
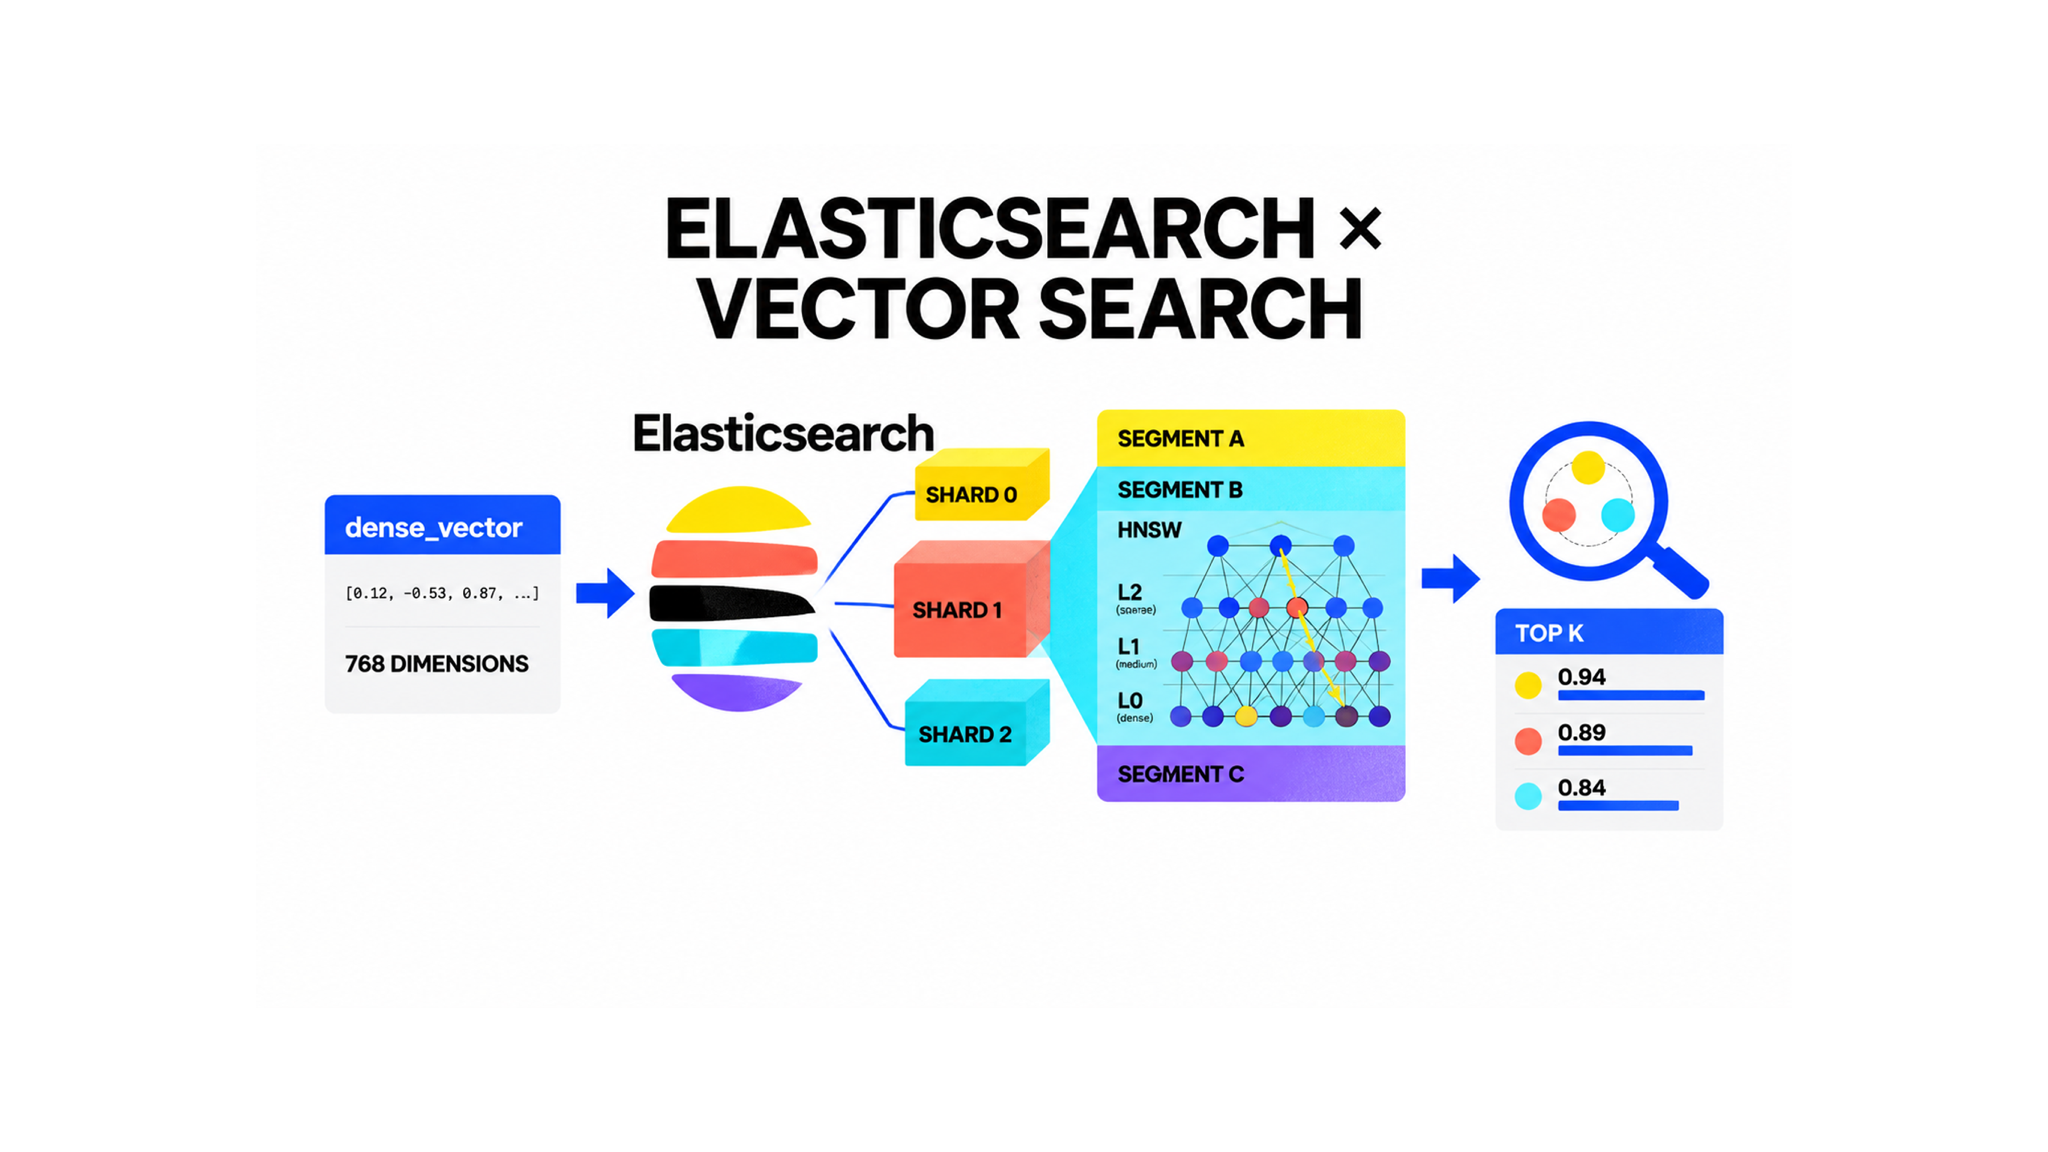
Elasticsearch 如何存储与检索海量向量
Elasticsearch 如何存储并检索 TB 级海量向量?本文从集群、分片、Lucene segment 和操作系统页缓存四个层次展开,系统讲解向量数据与 HNSW 图的磁盘组织方式、文档路由与副本机制、分布式 kNN 查询的 scatter-gather 链路,以及 int8、BBQ 量化和 force merge 等低延迟优化手段,帮助读者理解 Elasticsearch 向量检索背后的完整工程实现。
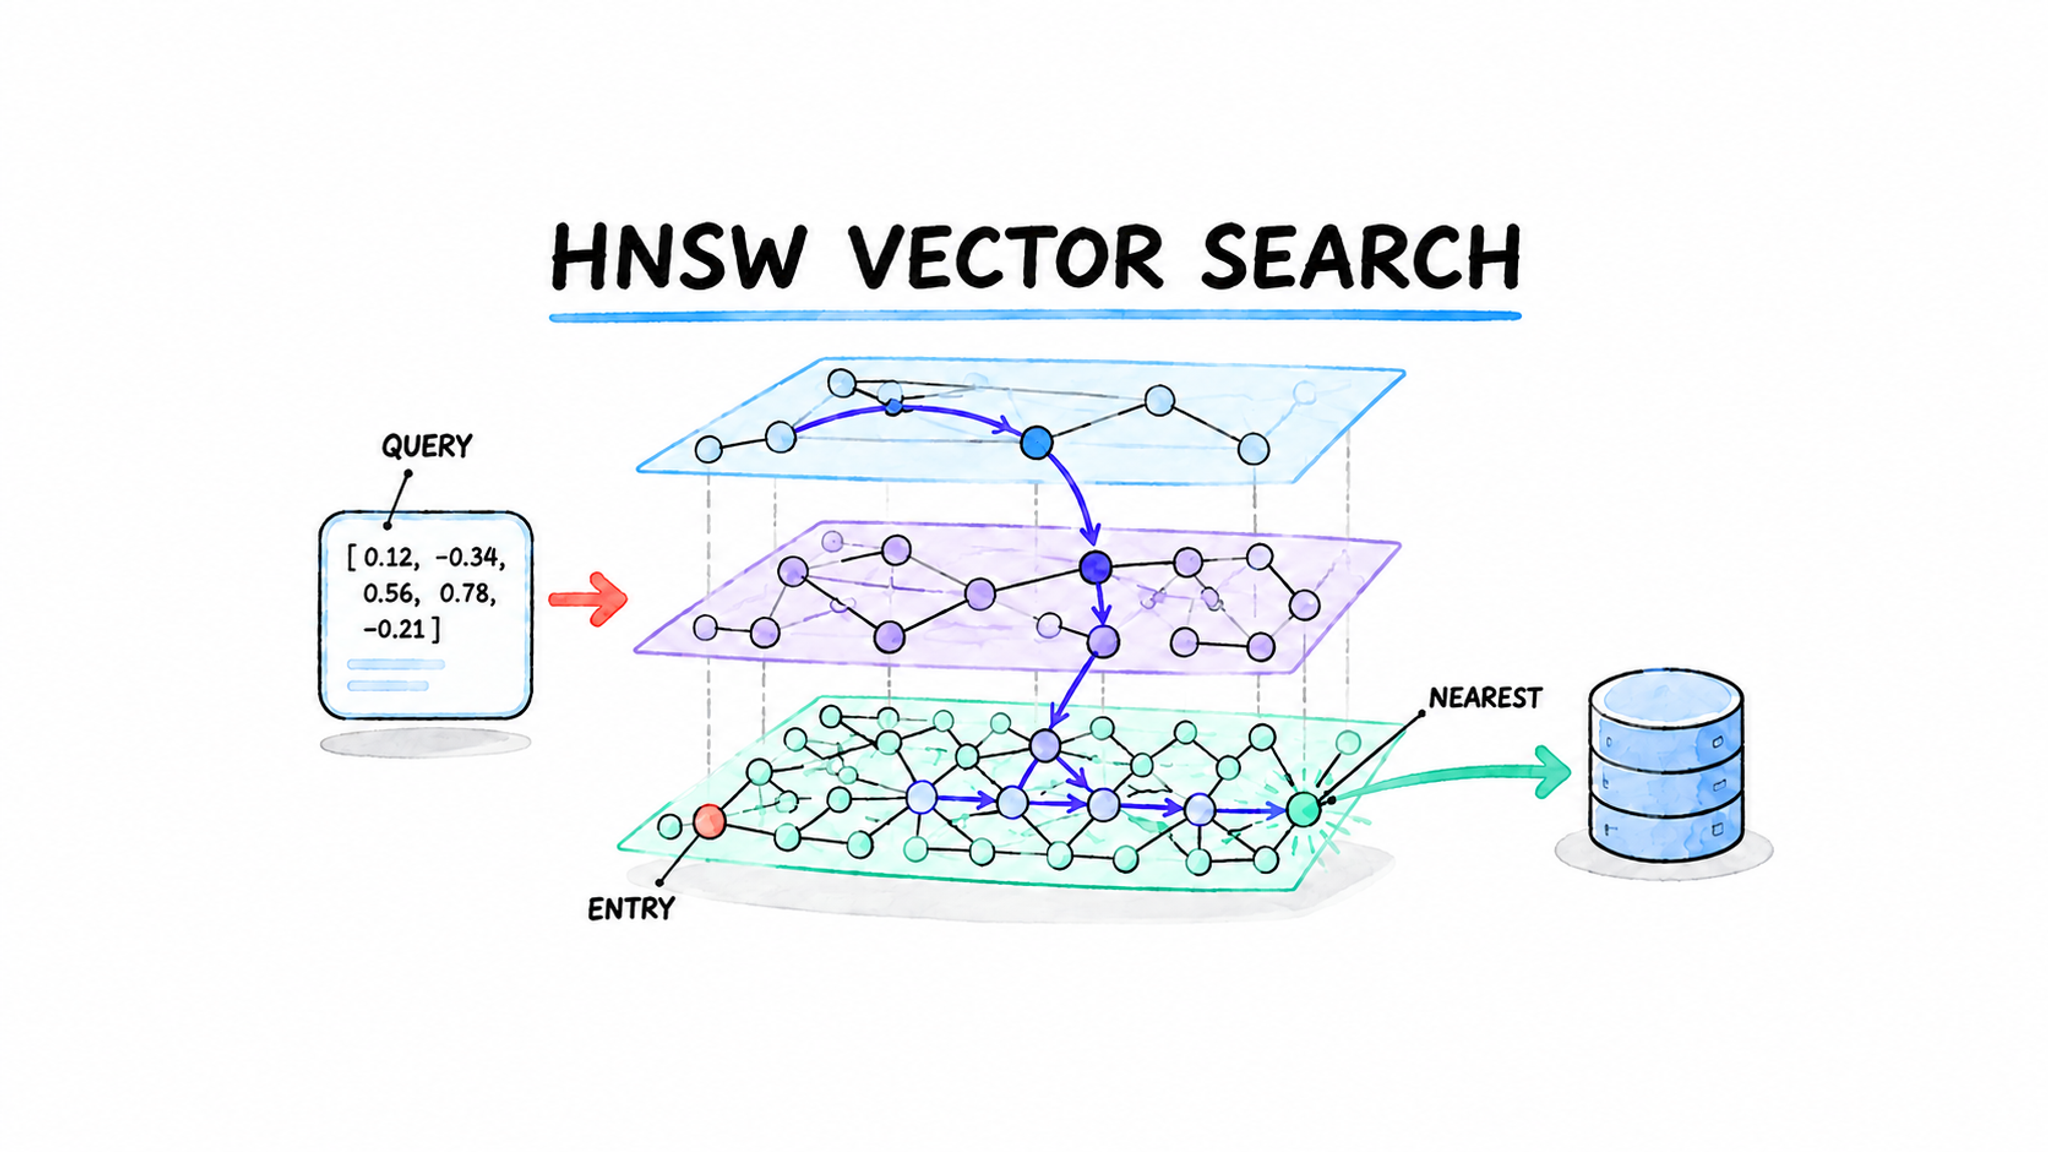
向量数据库如何搜索海量数据?大白话讲透 HNSW
向量数据库如何从海量数据中快速找到最相似的结果?本文从暴力检索和基于图的查找讲起,逐步拆解 NSW 的小世界图、高速公路连接与近邻搜索过程,并结合跳表解释 HNSW 的分层结构、查询流程和启发式邻居选择算法,帮助读者直观理解 HNSW 如何在检索速度、资源消耗与召回率之间取得平衡。
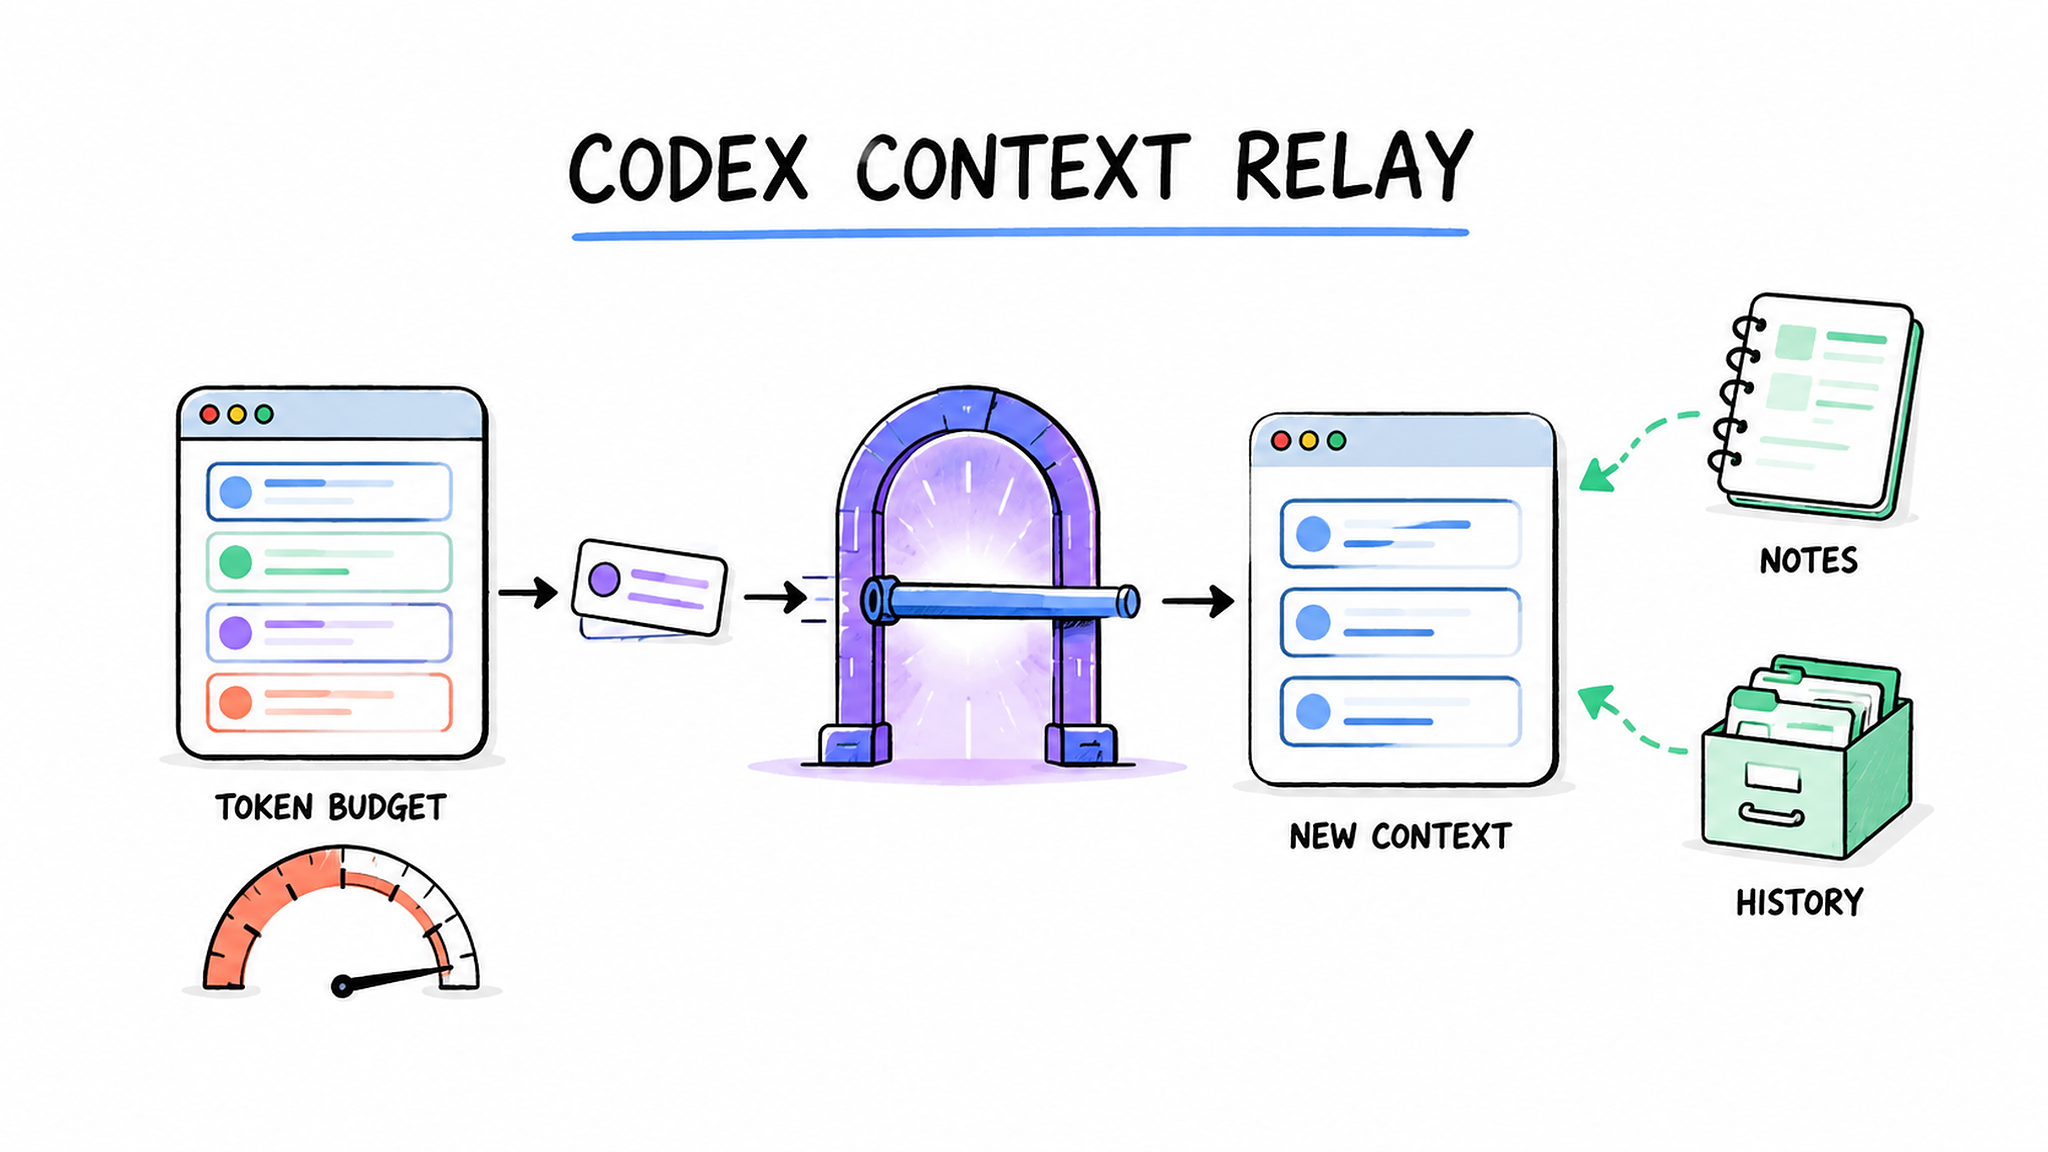
Codex 要抛弃传统上下文压缩了?Token Budget、硬切换与外部记忆如何接力
Codex 并未全面放弃上下文压缩,而是在实验性上下文管理模式中,用 Token Budget、Notes、History 与 new_context 取代自动摘要式压缩。本文拆解新旧 compaction 路径的差异、窗口切换后的任务恢复机制、潜在失效风险,以及 Codex CLI 0.153.4 中的开启方式与账号限制,帮助开发者理解 AI 编程 Agent 如何通过主动 checkpoint、工作集重置和按需历史检索延续长任务。

Agent 的长期记忆如何优雅实现?深入拆解 Mem0 的记忆框架实现
为什么大模型能读百万字,却记不住你上周说过的不吃香菜?本文从源头拆解 Mem0 开源版(OSS)的记忆框架实现,揭示长期记忆不是"把聊天存下来再塞回 Prompt",而是一套覆盖提取、检索、演化与治理的完整生命周期。文章首先厘清全量历史重放、摘要压缩、普通向量 RAG 三种方案的局限,进而深入 Memory.add() 的写入链路:最近消息窗口解决指代、相关旧记忆辅助去重、提取提示词决定写入质量、MD5 与语义双层去重。重点剖析 V3 最反直觉的改动——放弃自动 UPDATE/DELETE、只做 ADD-only,以保护历史轨迹,代价是存储膨胀与读取端治理。检索层面拆解语义搜索、BM25 关键词、Entity Store 实体加分三路信号融合的 semantic-gated hybrid ranking 机制,以及 Reranker 的适用边界。最后梳理三套存储(主向量库、SQLite History、Entity Store)的一致性代价、可插拔能力差异,并坦诚指出 LLM 提取有损、中文多语言需重新评测、记忆系统不应替代业务数据库等生产问题,帮助开发者在构建跨会话个性化与 Agent 状态管理时做出更合理的技术决策。
Claude Code 上下文管理与压缩策略深度解析
Claude Code 是 Anthropic 出品的 AI 编程 CLI 工具。本文基于 2026 年 3 月泄露的 Claude Code v2.1.88 源码(51 万行 TypeScript),通过一个完整的真实场景——“小明用 Claude Code 重构 React 项目”——带你从第 1 轮对话走到第 50 轮,亲历上下文膨胀、触发压缩、信息取舍的全过程。即使你没看过一行源码,也能彻底理解 Claude Code 的上下文管理体系。
一、故事的起点:一次令人困惑的”失忆”小明是一名前端开发者,正在用 Claude Code 重构一个老旧的 React 项目——把 Class 组件全部迁移到函数组件 + Hooks。
第 1 轮,小明说:”帮我把这个项目的 Class 组件全部改成函数组件 + Hooks,用 TypeScript,别再写任何 Class 组件了。”
Claude Code 表现完美。接下来的 40 多轮对话中,它读文件、改代码、跑测试,一个接一个地完成了组件迁移。
然后,第 45 轮,小明让它重构 Dashboard.tsx。Clau ...
MCP传输协议演进:从SSE到Streamable HTTP
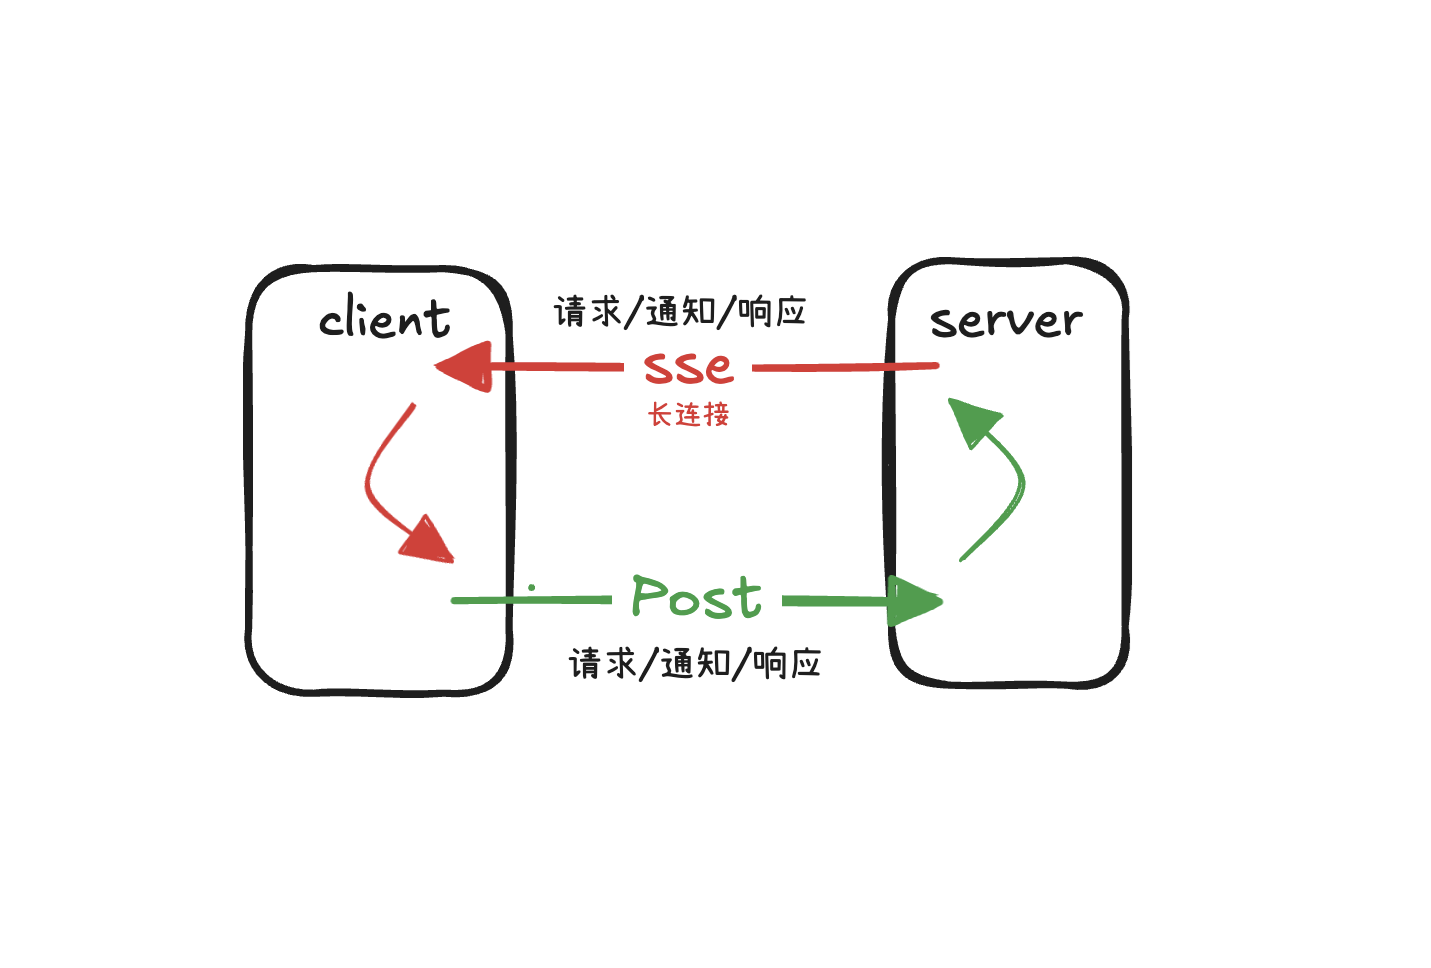
本文梳理了 MCP 协议从 stdio、HTTP+SSE 到 Streamable HTTP 的三代传输演进,详解 SSE 原理与旧方案痛点,并重点解析新一代 Streamable HTTP 的设计思路、交互流程与优势改进。
Token 节省利器:Claude Agent Skills 使用与原理解析
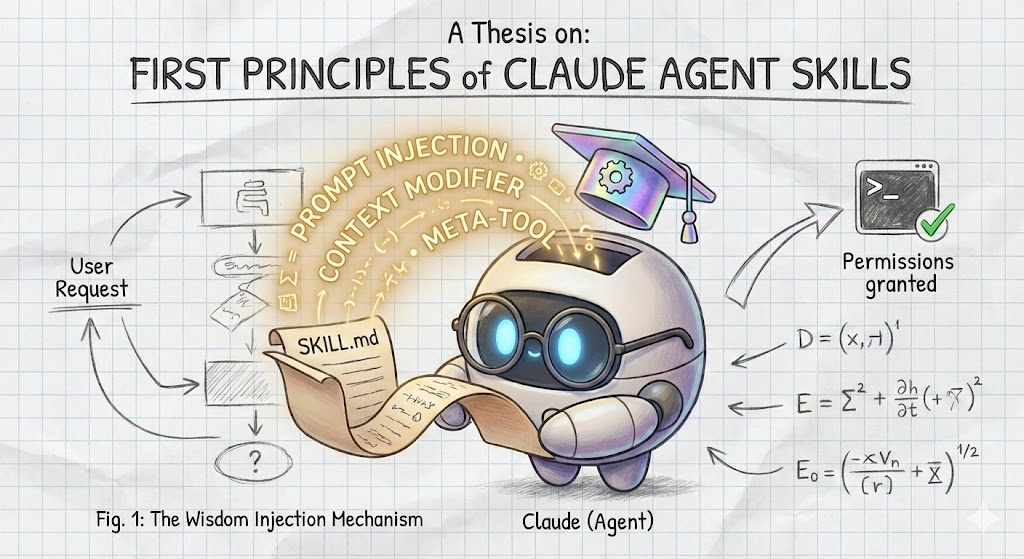
Claude Agent Skills 以 “按需加载” 为核心,通过渐进式披露与双重上下文注入实现 token 高效利用,既解决了 LLM 领域专业化与上下文臃肿的矛盾,又支持开发者按规范快速创建自定义技能。本文聚焦其实际使用、自定义开发流程与底层技术原理,为开发者提供兼顾实用性与技术深度的实战指南。
超越 ReAct:探寻Plan-And-Execute Agent的设计与实现原理
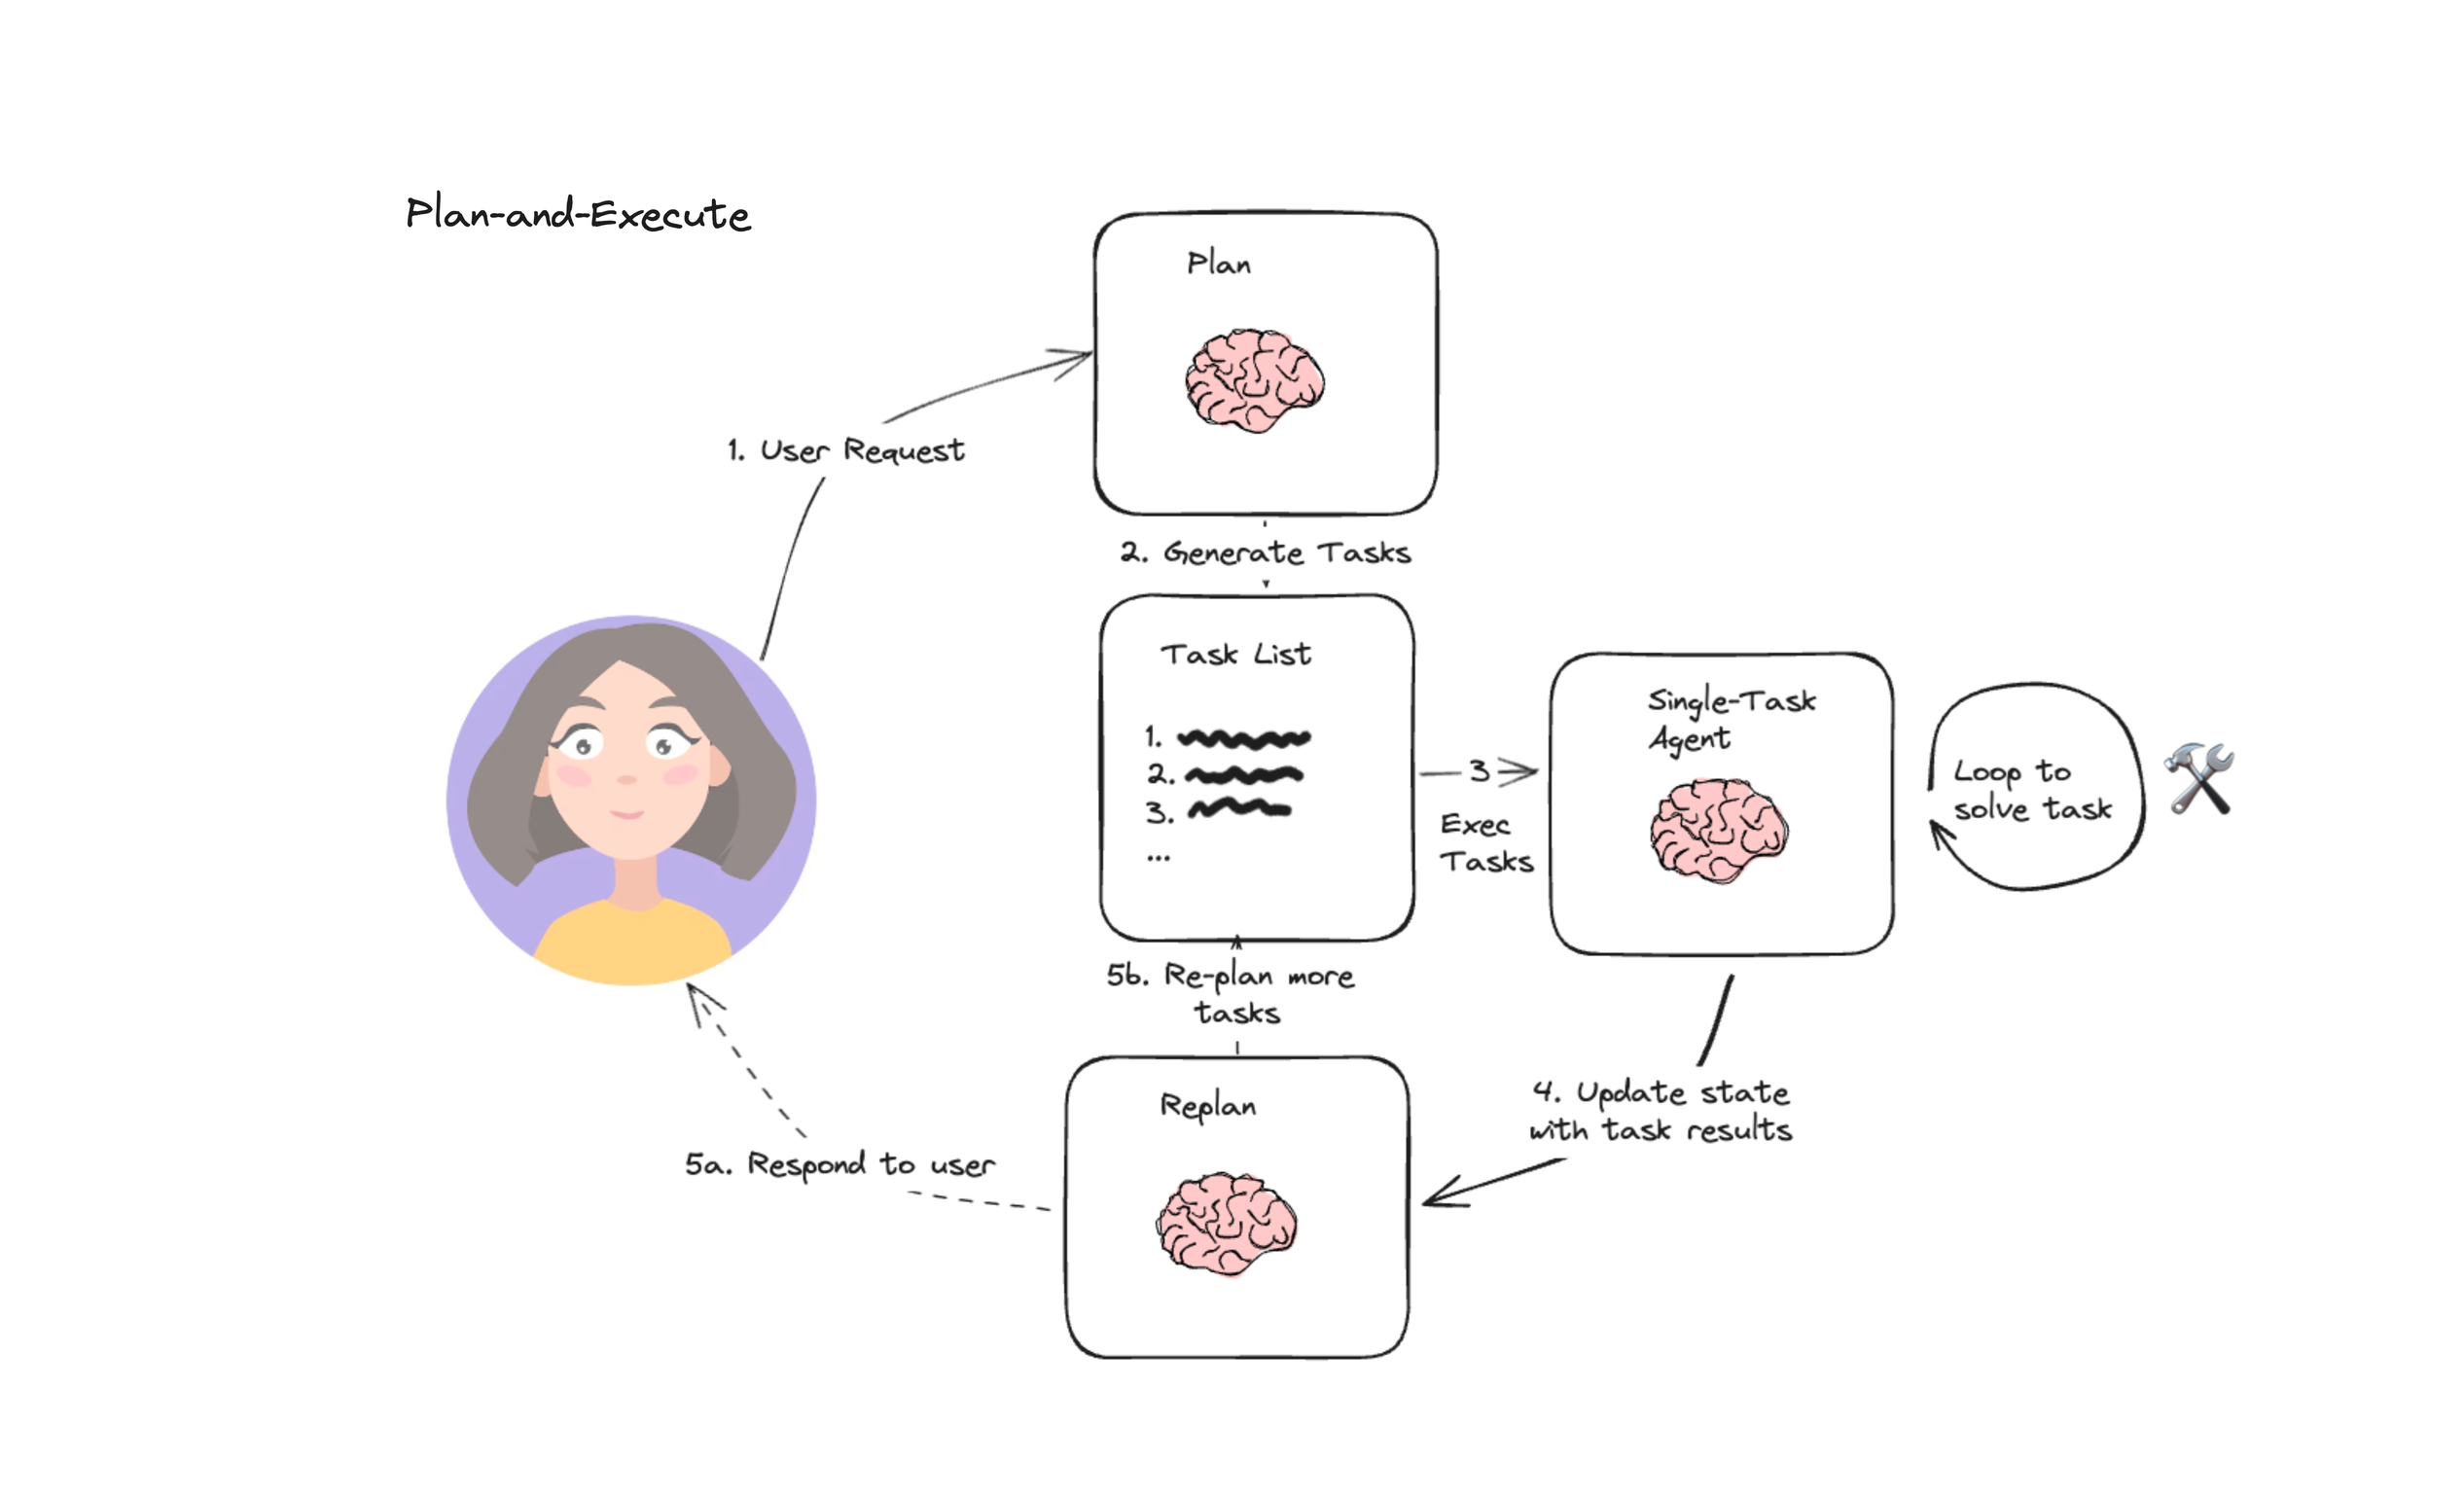
本文围绕 Plan-And-Execute 智能体展开系统解析,通过对比 ReAct 模式,阐明其在复杂任务中 “全局规划 + 动态调整” 的核心优势。文章依次拆解规划器、执行器、重新规划器、最终答案生成器四大核心组件的职责与协作逻辑,梳理 “规划 - 执行 - 整合” 的完整工作流程,并基于 LangChain 框架实现了从环境搭建、组件开发到全流程串联的实战案例,清晰呈现该类智能体的设计原理与落地细节,为复杂任务的智能处理提供了可行方案。
初探Nebula Graph核心架构设计
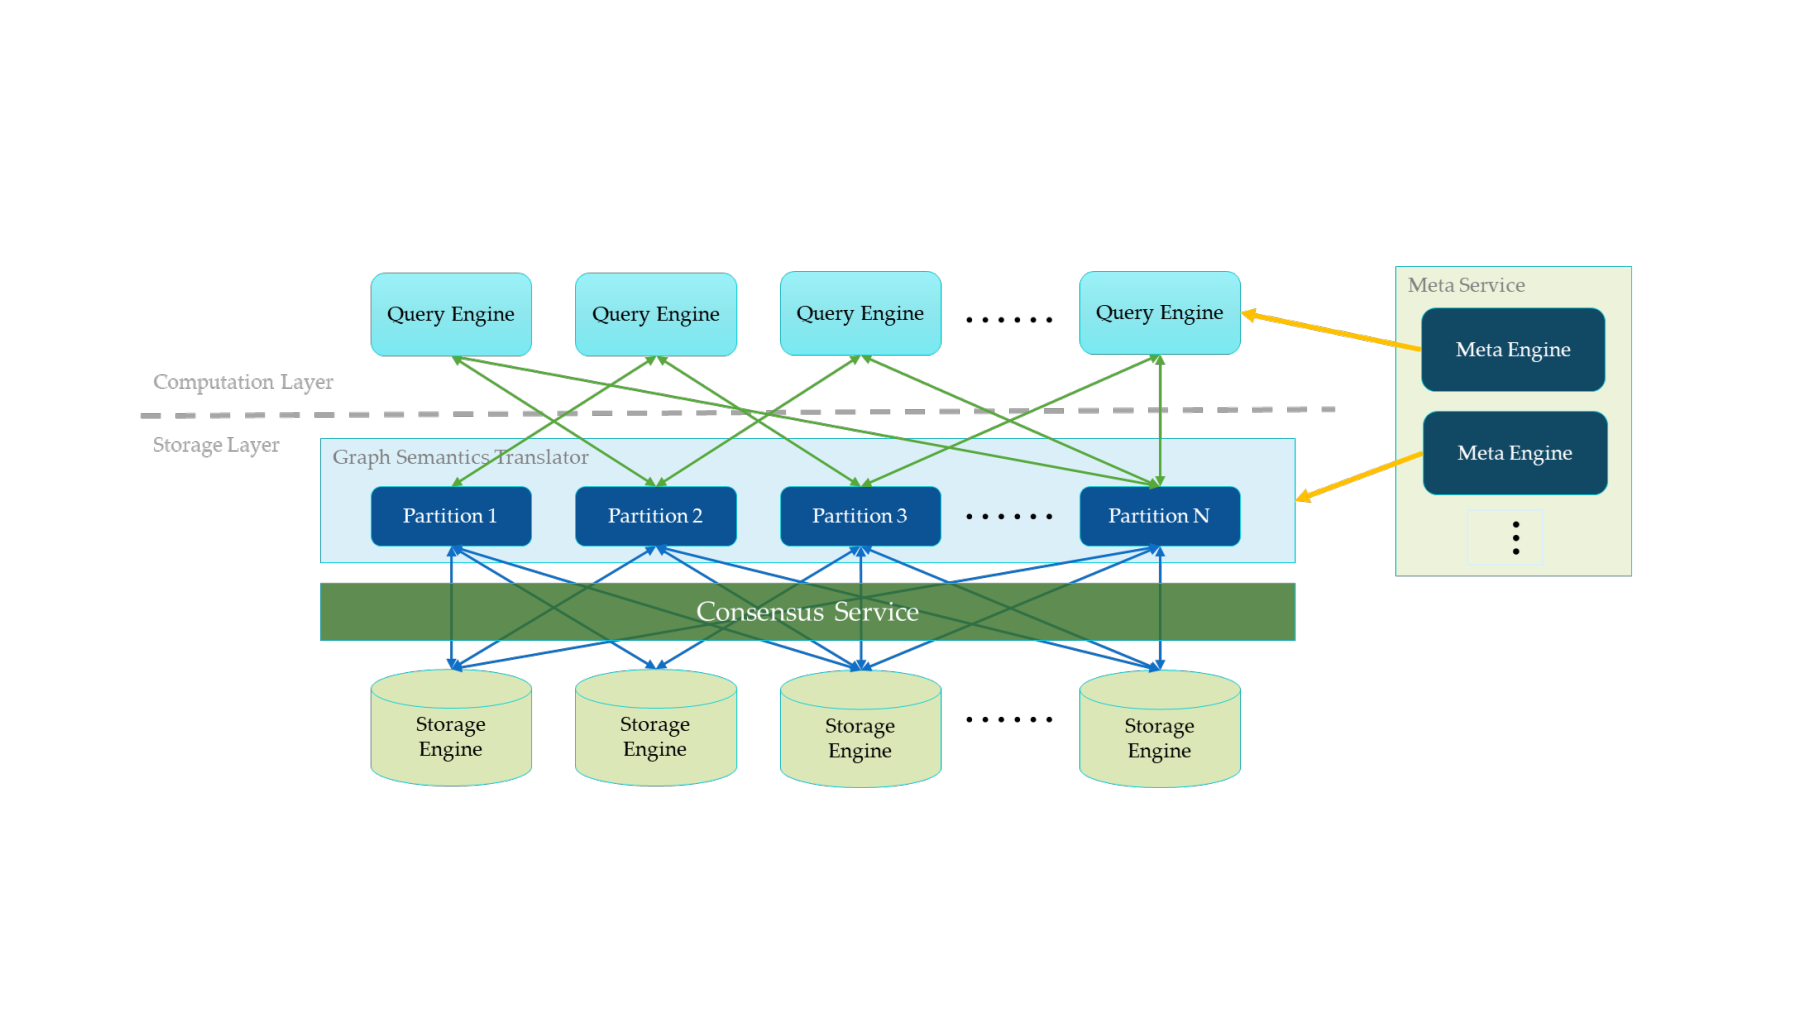
随着图数据在金融风控等场景的广泛应用,大规模关联数据的高效存储与低延迟查询成为核心需求,传统数据库难以兼顾超大规模与高并发查询的痛点日益凸显。Nebula Graph 作为分布式图数据库,采用 Meta Service、无状态计算层、Shared-nothing 存储层的三层架构,通过存算分离设计实现计算与存储资源的独立弹性伸缩。其核心技术包括以 Vertex ID 哈希分片的 Partition 机制、基于 RocksDB 的本地存储优化、图数据与 KV 结构的高效映射,以及 Raft 协议保障的多副本一致性。本文从整体架构、存储设计、查询流程及 Raft 同步原理等维度,梳理 Nebula Graph 的关键技术实现,为大规模图数据处理场景提供技术参考。
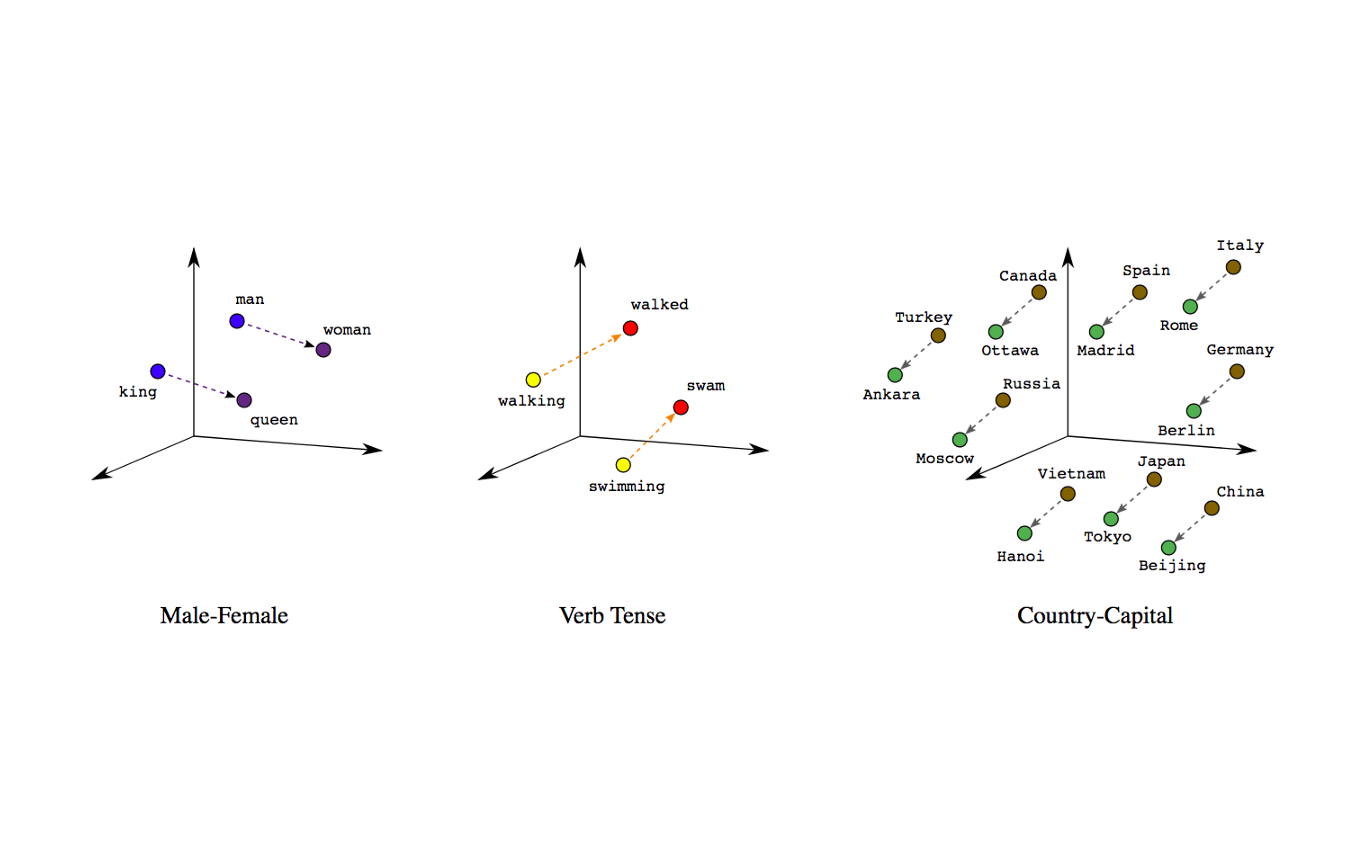
AI 如何“读懂”文字?词嵌入向量的底层逻辑、实现与可视化
词嵌入(Word Embedding)是大型语言模型(LLM)理解人类语言的核心基础,它解决了传统独热编码的维度爆炸、语义鸿沟等痛点,通过将离散单词映射为低维稠密向量,实现了对词汇语义和句法特征的精准捕捉。本文从语言表示的底层逻辑出发,系统梳理了词嵌入的技术演进:从 Word2Vec 的 CBOW 与 Skip-gram 模型、GloVe 的全局统计信息融合,到 FastText 的子词单元创新,再到现代 Transformer 架构中上下文相关的动态嵌入。结合阿里百炼平台的实战案例,通过词向量可视化、语义相似度计算等代码实现,直观展示了 “语义相似词在向量空间中距离相近” 的核心特性。同时,本文深入分析了词嵌入的优劣势,并揭示其在大模型中的关键作用 —— 作为语言理解的 “桥梁”,连接符号化文字与模型可处理的数值特征。无论你是 AI 技术学习者、大模型应用开发者,还是希望深入理解 LLM 底层机制的工程师,都能通过本文掌握词嵌入的核心原理、实践方法与工程价值,为后续 LLM 应用开发(如 LangChain 集成、语义检索等)奠定基础。