向量数据库如何搜索海量数据?大白话讲透 HNSW
向量数据库如何搜索海量数据?大白话讲透 HNSW(转)
作者:沧叔解码。原文:大白话理解HNSW。
背景介绍
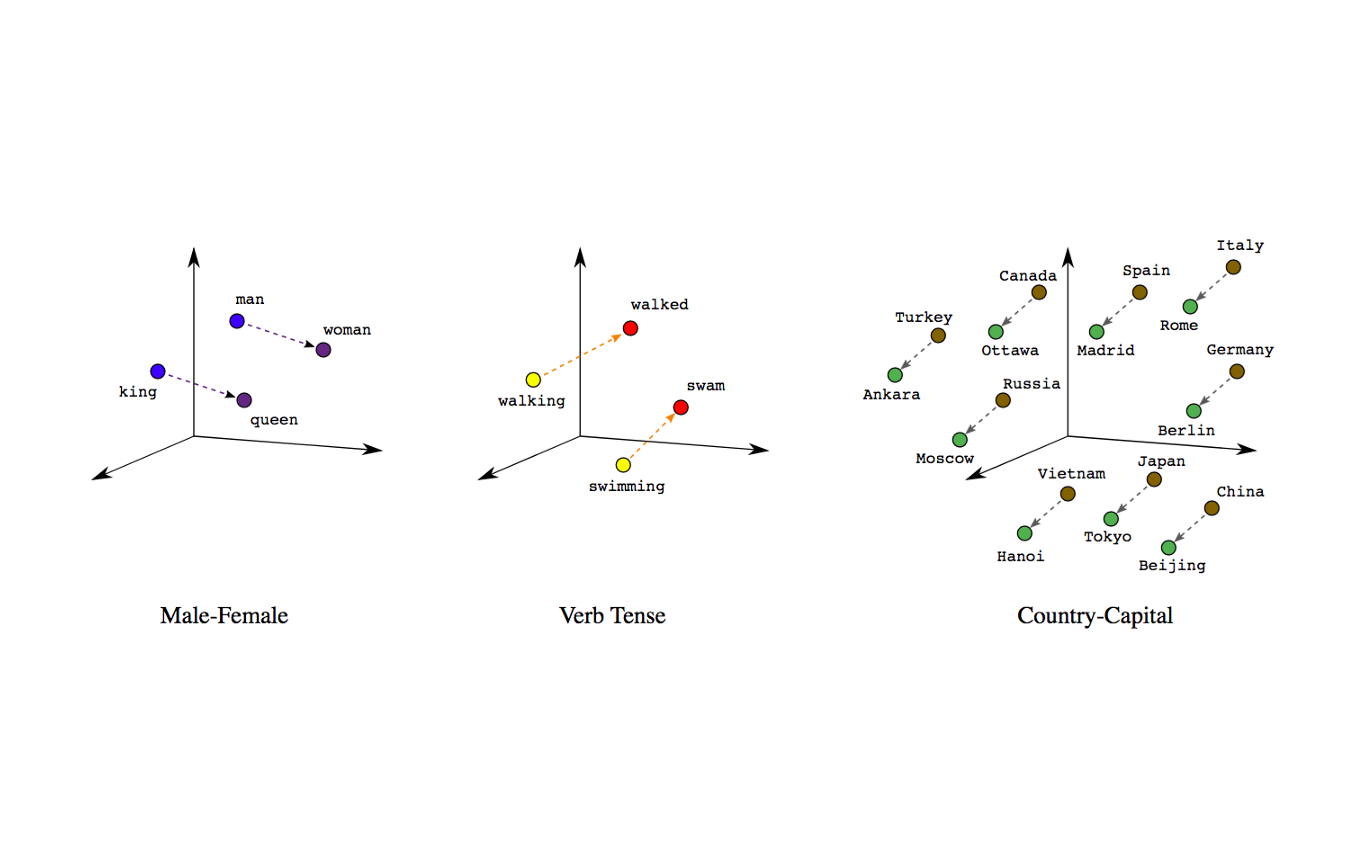
在语义检索领域,一般都是把待检索的文档集合提前编码成指定维度的向量入库。检索的时候把 query 也编码成同样维度的向量,然后在库里面根据指定的距离度量方式寻找距离最近的向量,也就是最相关的文档。
那么如何在使用尽量少的资源,又快又准地检索相关文档呢?
暴力检索
最容易想到的解决方式,是把 query 编码的向量拿到向量库中逐一计算距离,然后返回 topK 距离最近的向量所代表的文档。
这种查找方式当然能够找到真正的 topK 最相关文档,但是效率很低。也可以做一些优化,比如每次检索时随机取出向量库中的向量进行距离计算,再增加截断参数,只计算前 1 万个向量,然后从中选择 topK。但是这种优化并不是无损的:截断参数设置较低会影响召回质量,设置较大时效率依然低下。
那还能怎么优化呢?
基于图的查找
向量其实就是多维空间中的一个点,向量的近邻检索就是寻找空间中相近的点。
来看一个直观的例子。下图是二维平面,也就是二维向量空间中的一些黑色节点。问题是:怎么从这些黑色点中寻找离红点最近的点?
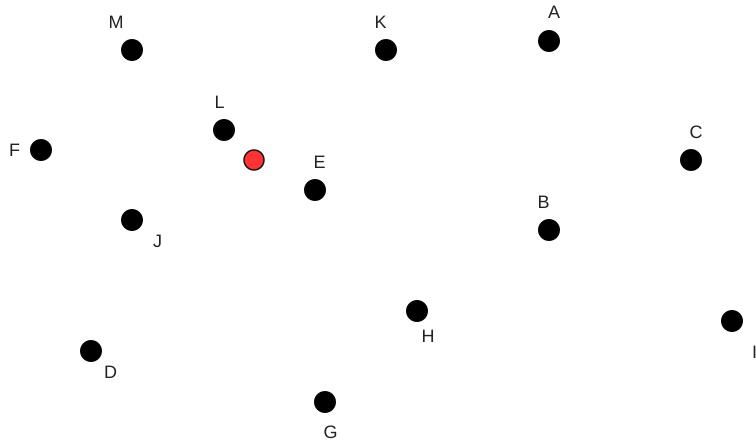
一种简单做法是把某些黑色点连接起来,构建一个查找图并存下来。与一个点直接相连的点称为这个点的邻居节点。
查找时,从某个黑色点,也就是起始遍历节点 entry point 出发,计算它和目标点的距离,然后再计算它的邻居节点和目标点的距离,选择距离目标节点最近的节点继续迭代。如果当前处理的黑色节点比它的所有邻居节点距离目标节点都近,那么就把当前节点作为最近节点。
假设对上面的黑色节点构建了如下的图,entry point 是 I,要寻找距离红色节点最近的节点。
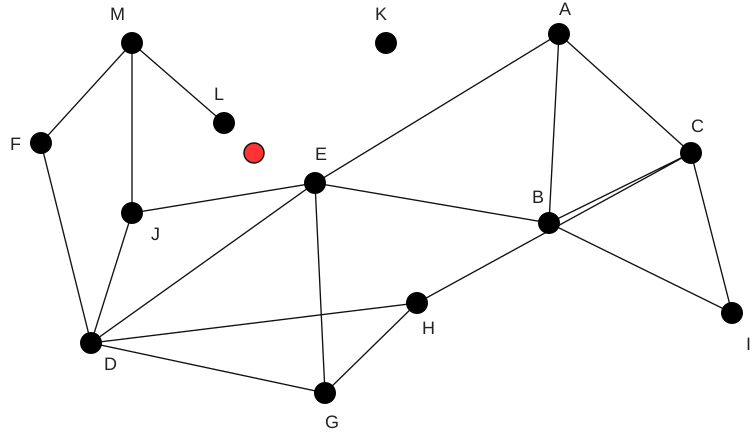
查找过程如下:
先计算 I 和红色节点的距离并记录下来,再计算 I 的邻居节点 [B, C] 和红色节点的距离。对比三个距离后发现 B 最近,于是保存 B 到红色节点的距离,继续处理 B 的邻居节点 [A, C, I, H, E]。此时发现 E 最近,再计算 E 的邻居节点 [J, B, G, D]。最终发现仍然是 E 最近,于是返回 E。
从这个例子中可以发现,这种思路虽然行得通,但是存在一些问题:
- 找到的结果不是最优结果,最优结果应该是 L。
- 如果要返回最近的两个节点,而 L 和 E 之间没有连线,就会增加迭代次数并影响效率。
- K 是一个孤岛。如果初始节点不是 K,就永远无法访问到 K;如果 K 是初始节点,又无法遍历其他节点,只能返回 K,误差较大。
- 如何确定哪些节点应该互为邻居?
针对这些问题,粗暴而直观的解决方案是:
- 距离近到一定程度的节点必须互为邻居,解决问题 2、4,并降低问题 1 出现的概率。
- 所有节点都必须有邻居,解决问题 3。
这个直观方案能否用更严谨、可实现的方式描述?
NSW(Navigable Small World Graphs)
Navigable Small World Graphs:可导航的小世界图
德劳内算法
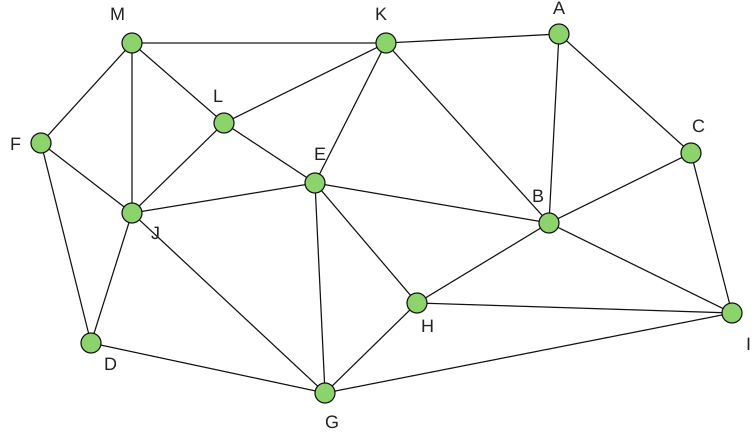
图论中有一个剖分法可以有效解决上一节的问题,即 德劳内(Delaunay)三角剖分算法。它对一批空间节点处理后,可以达到以下效果:
- 图中的每个节点都有邻居节点。
- 距离相近的节点互为邻居。
- 图中的连接线段数量最少,也就是邻居对最少。
实际效果如下:
但是德劳内三角剖分有两个缺点:
- 图的构建时间复杂度太高。
- 查找效率较低。如果起始点和目标点距离很远,需要大量迭代才能找到目标。
由于这两个缺点,NSW 并没有直接使用德劳内三角剖分。为解决这些问题,NSW 做了两个改进:
- 使用局部信息构建图,降低构建复杂度。
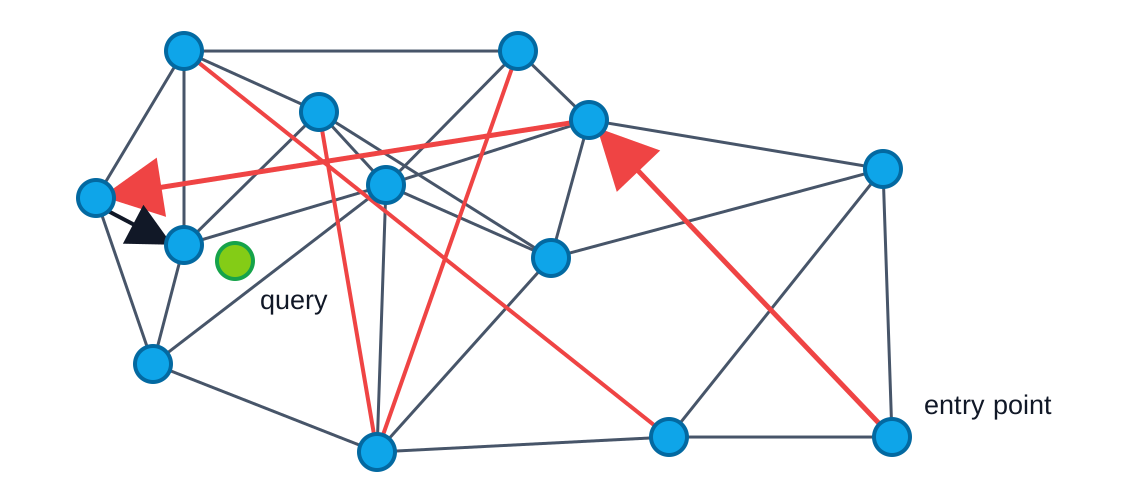
- 使用局部信息构图会产生一些“高速公路”,如下图中的红色连线。距离较远的节点也可能互为邻居,从而提升迭代效率。例如从 entry point 开始查找绿色节点,通过红色箭头所示的路线就能快速接近目标。
NSW 构建算法描述
NSW 的构建算法非常简单:遍历所有待插入节点。每新增一个节点时,从当前图中的任意节点出发,寻找距离新增节点最近的 m 个节点作为邻居;把新节点加入图中,并连接新节点和它的所有邻居节点。
NSW 构建例子
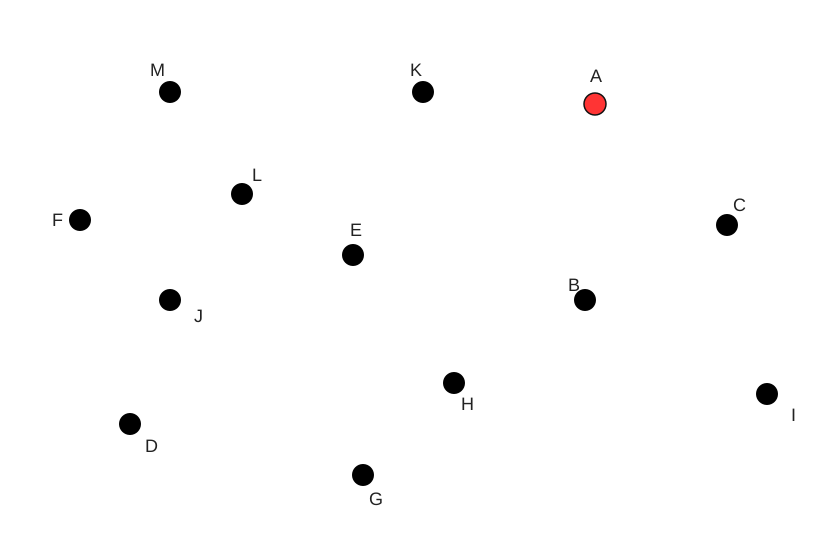
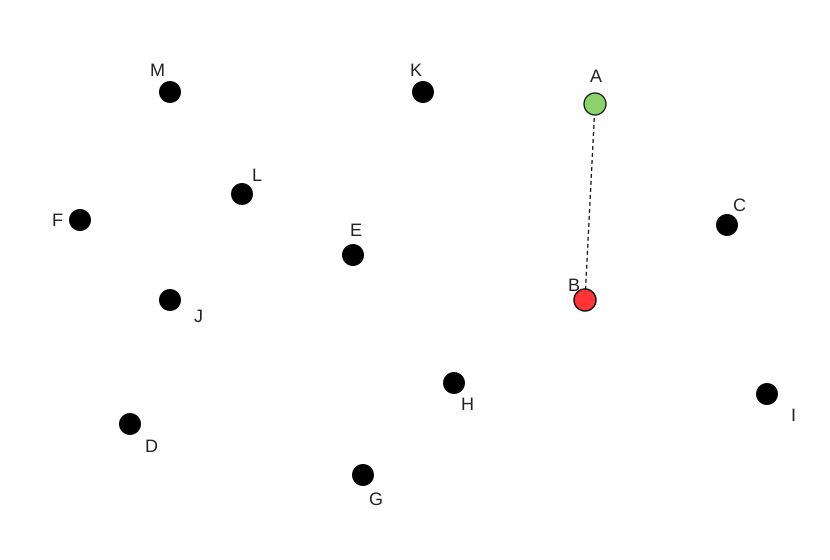
下面用一个例子说明。节点按字母顺序处理,并规定最多查询 3 个邻居:
- 黑色节点表示待插入的节点。
- 红色节点表示当前处理的节点。
- 绿色节点和实线表示已经构建好的图。
- 虚线表示当前节点和候选邻居节点的连线。
- 红色连线表示“高速公路”。
第 1 步:加入节点 A。 此时图中只有节点 A。
第 2 步:加入节点 B。 此时 B 只有一个邻居节点 A。
第 3 步:加入节点 C。 此时 C 的邻居节点是 [A, B]。
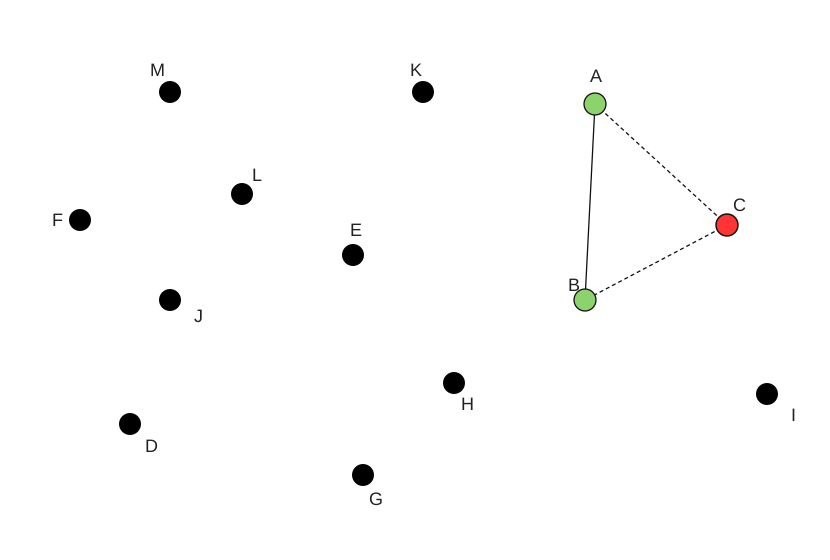
第 4 步:加入节点 D。 此时 D 的邻居节点是 [A, B, C]。
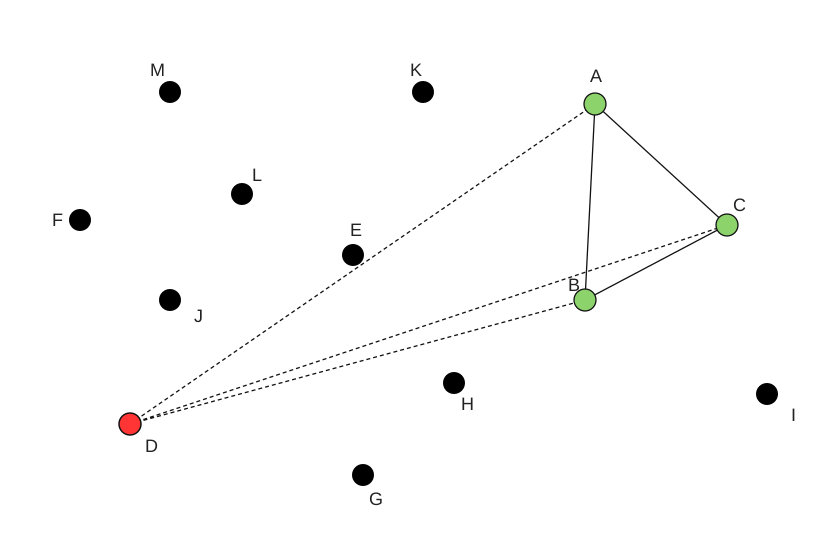
第 5 步:加入节点 E。 此时 E 的邻居节点是 [A, B, D]。
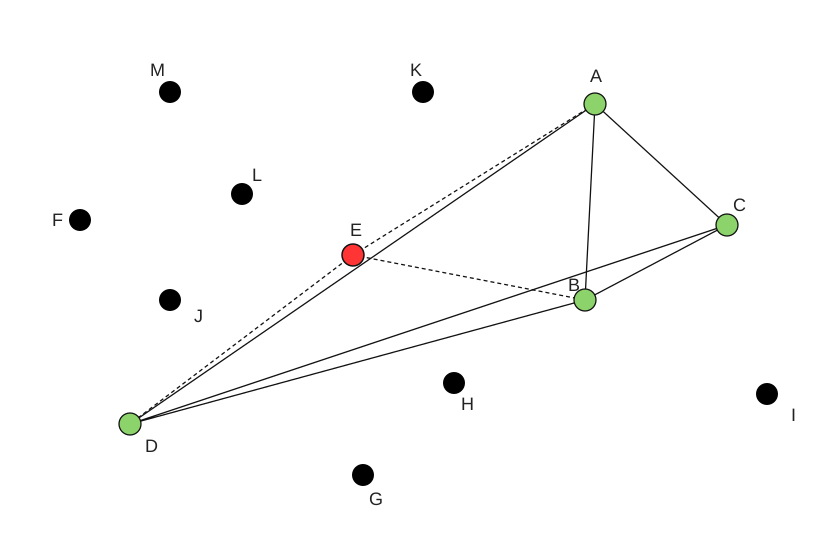
第 6 步:加入节点 F。 此时 F 的邻居节点是 [B, D, E]。
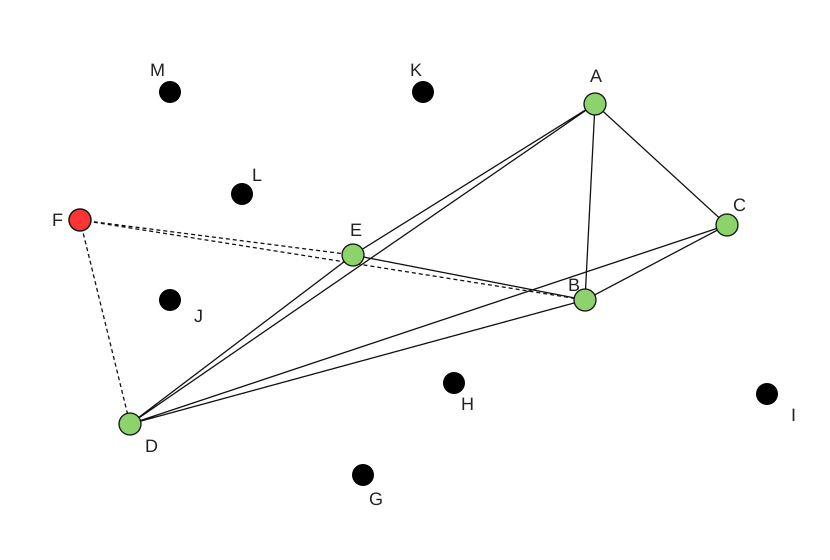
第 7 步:加入节点 G。 此时 G 的邻居节点是 [B, D, E]。
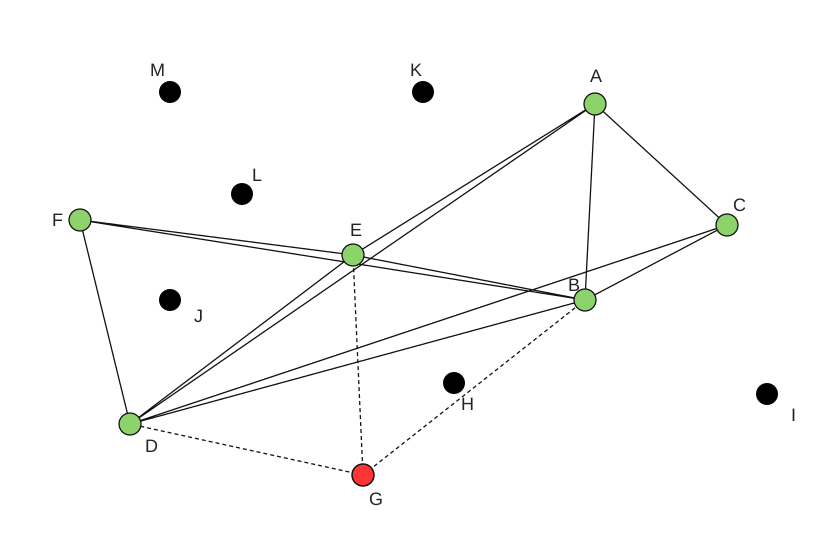
第 8 步:加入节点 H。 此时 H 的邻居节点是 [B, E, G]。
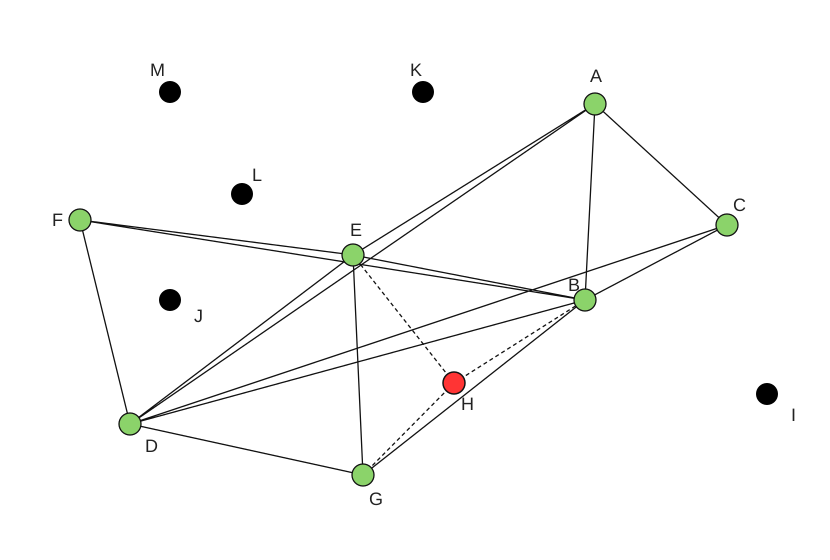
第 9 步:加入节点 I。 此时 I 的邻居节点是 [B, C, H]。
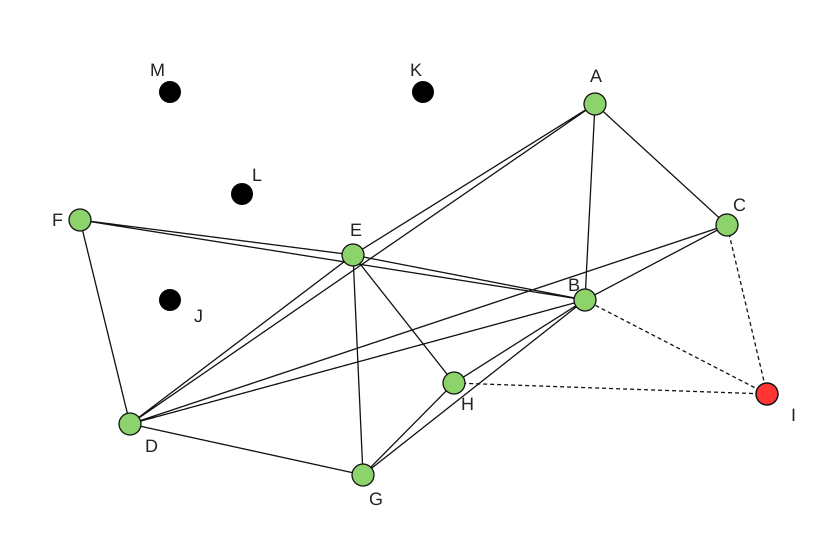
第 10 步:加入节点 J。 此时 J 的邻居节点是 [D, E, F]。
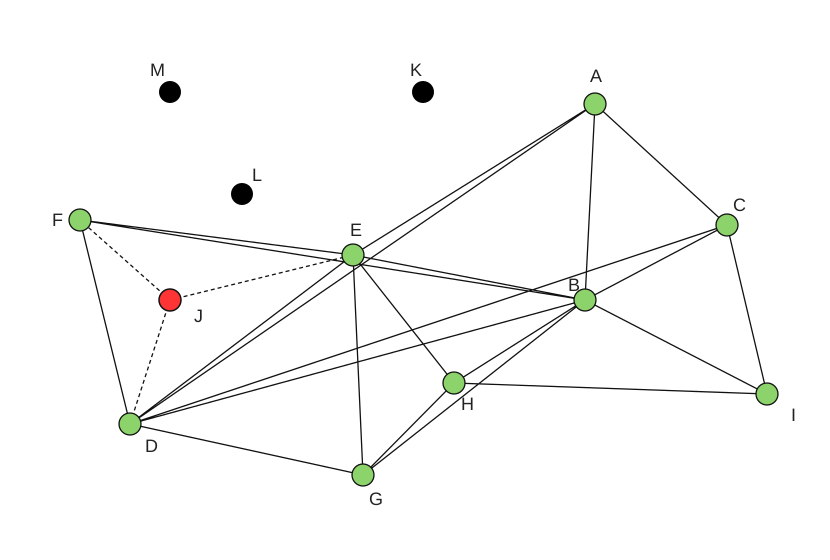
第 11 步:加入节点 K。 此时 K 的邻居节点是 [A, B, E]。
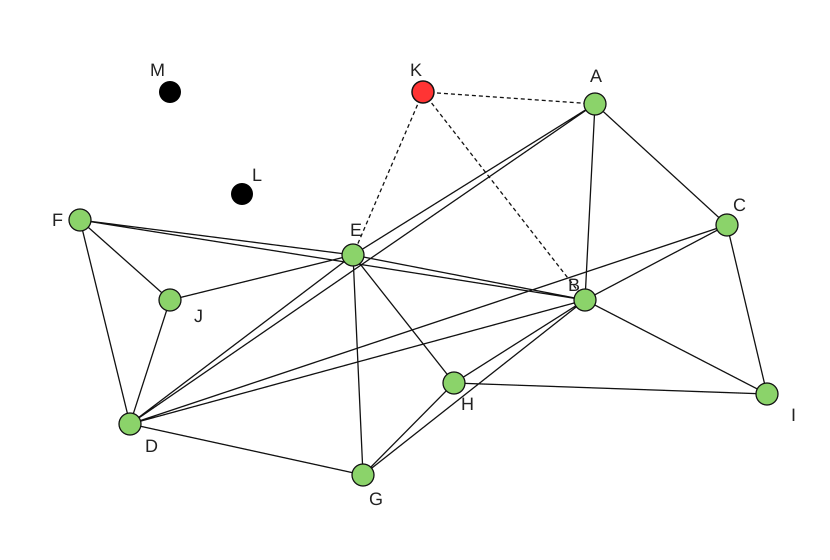
第 12 步:加入节点 L。 此时 L 的邻居节点是 [E, F, J]。
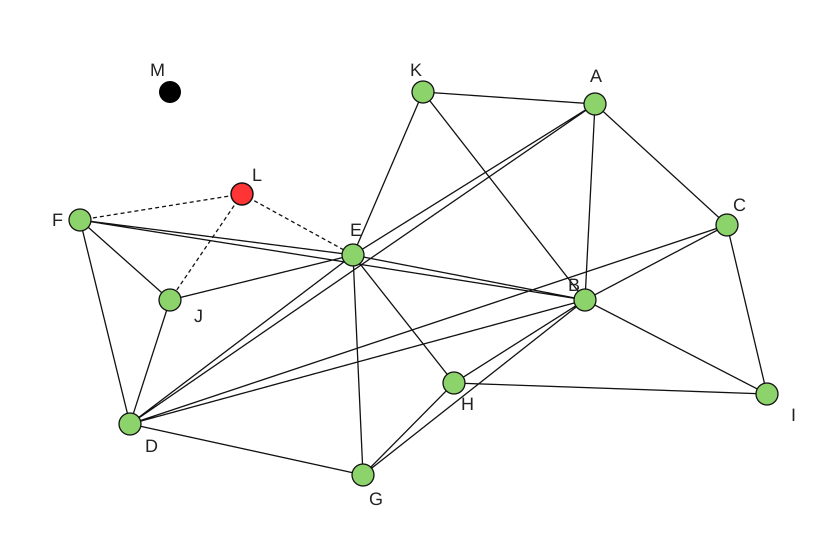
第 13 步:加入节点 M。 此时 M 的邻居节点是 [F, J, L]。
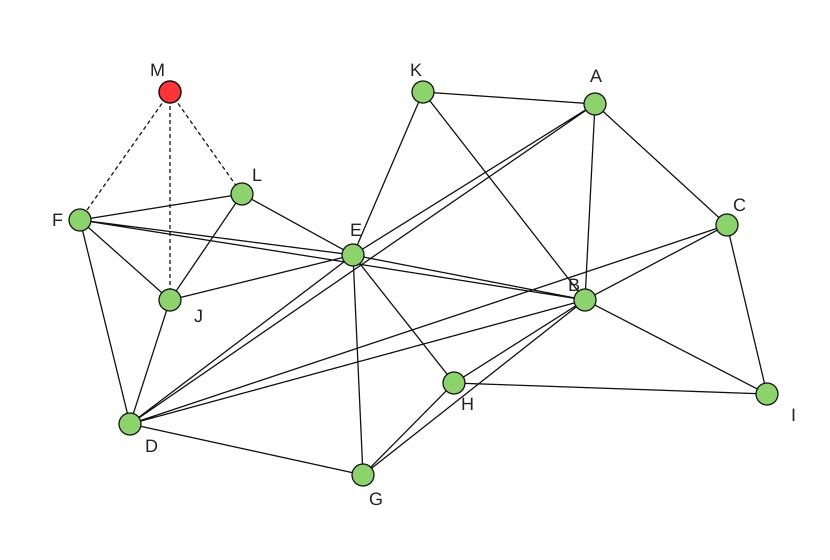
最终构建完成的图如下。其中红色线条就是“高速公路”,可以提高查找效率。
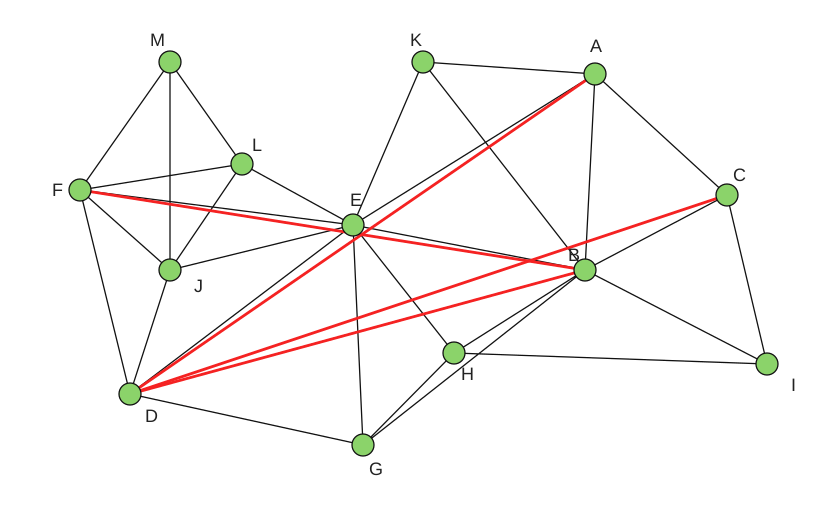
德劳内和 NSW 构建结果对比
对比德劳内构建的结果:
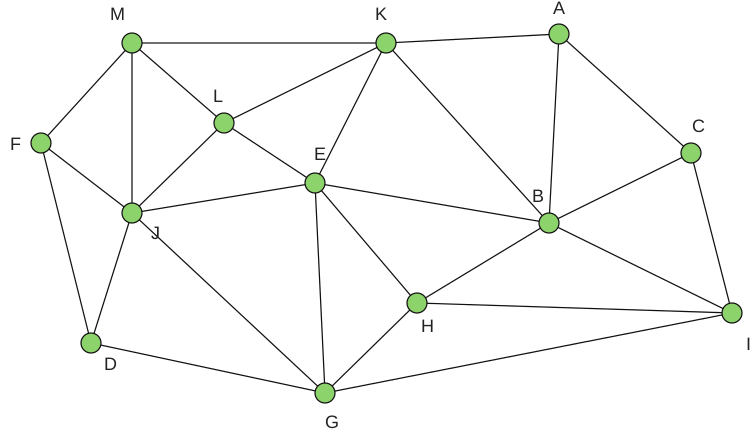
如果从 I 开始查找 F 附近的节点,德劳内构建的图需要多次迭代,而 NSW 可以通过高速公路快速找到。
大白话理解 NSW
从感性上理解,NSW 构建过程中节点是随机加入的。为当前加入的节点寻找邻居时只使用局部信息,所以前期加入的节点所找到的邻居很可能并不是真正的最近邻。全局来看,距离较远的节点可能会互为邻居,这就形成了“高速公路”。同时,新增节点只需要直接查询最近的邻居,算法复杂度较低。
NSW 的查找算法
NSW 的查找算法用于在已经构建好的 NSW 图中,查找目标节点 q 的 k 个近邻点。
算法依赖两个堆和一个位图来优化查询速度:
visited:记录已经查找过的节点。candidates:候选节点的最小堆,堆顶是距离目标节点最近的候选节点。results:当前结果节点的最大堆,堆顶是距离目标节点最远的结果节点。
算法步骤如下:
- 建立最大堆
results、最小堆candidates和位图visited。 - 随机选择一个节点作为起点,加入
visited,计算它到目标节点的距离并加入candidates。 - 从
candidates中获取堆顶候选节点,也就是其中距离目标节点最近的节点。 - 如果当前候选节点到目标的距离,大于
results堆顶节点到目标的距离,并且results的大小已经满足 topK,则结束迭代。 - 否则遍历候选节点的所有邻居。如果邻居没有出现在
visited中,就把它加入candidates和visited。 - 返回第 3 步继续执行。
下面通过一个具体例子观察三个容器的变化。设 topK = 2,从入口节点 S 开始搜索。节点旁的数字表示它到查询点 q 的距离,数字越小,表示节点与 q 越相似。
图中实际展开顺序为 S → A → B → E → G,最终返回 G 和 E。此时候选堆中虽然还有 F、C、D,但最接近的候选 F 距离为 5,已经大于当前结果中最远的 E 的距离 2,因此可以提前结束搜索。
论文还会为第 3 至第 5 步增加一个迭代限制参数 m,也就是最多执行 m 轮查找,从而在查询时延和准确度之间进行权衡。这里的查询步骤与论文中的伪代码略有差别,原始描述可以参见文末论文。
NSW 已经是一个比较优秀的近邻查找算法,但还可以进一步优化,于是就有了 HNSW。
NSW 的关键思路,是在局部邻接边之外保留一些远距离连接,让搜索能够借助这些“高速公路”快速接近目标区域。不过,NSW 仍然存在几个问题:
- 所有节点都处于同一层。 搜索近邻和进行远距离跳转都依赖同一张图。数据量增大后,即使存在高速公路,也可能需要在大量节点之间反复尝试才能接近目标。
- 高速公路的产生具有随机性。 远距离连接主要来自节点插入顺序和局部搜索结果,它们出现在哪里、能够跨越多远都不稳定。某些区域可能拥有很好用的捷径,某些区域则可能缺少有效的远距离连接。
- 搜索容易在效率和召回率之间拉扯。 搜索范围较小时,算法可能停在局部最优位置,漏掉真正的近邻;扩大候选集合和迭代次数虽然可以提高召回率,却会增加距离计算次数和查询延迟。
- 一张图同时承担“导航”和“精确搜索”。 远距离边适合快速移动到目标附近,短距离边适合在局部寻找真正的 topK。把两种职责混在单层图中,很难同时把两者都做好。
一个自然的改进方向是:能否像跳表一样,把节点组织成多层结构?上层只保留少量节点和跨度较大的连接,用于快速导航;越往下节点越多、连接越细,最底层再完成精确的近邻搜索。HNSW 正是沿着这个思路,在 NSW 的基础上引入了分层结构。
HNSW(Hierarchical Navigable Small World Graphs)
Hierarchical Navigable Small World Graphs:分层可导航的小世界图。
在介绍 HNSW 和 NSW 的关系之前,可以先对比有序链表和跳表的关系。
有序链表和跳表
下图展示了同一批数据对应的跳表结构和查询路径:
跳表由多个有序链表组成,最底层有序链表包含全部节点。跳表有很多种优化构建方式,最朴素的方法非常直接:从最底层开始遍历每个节点,对每个节点抛硬币,如果是正面,就让它进入上一层的有序链表,并逐层重复。
查询目标时,有序链表只能从 header 开始向后遍历,直到找到目标,或者找到大于目标的最小节点后停止。跳表则从上往下查找,在每一层找到第一个小于等于目标的节点,然后向后或向下继续查找,停止条件与有序链表相同。
例如查找目标节点 59,有序链表从头向后查找需要 7 次,而跳表从上往下只需要 5 次。这个小例子中的差距并不明显,但在成千上万个节点的场景中差距会被放大。跳表通过增加层数,以空间换时间,提高查找效率。
跳表上层链表中的节点跨度较大,就像 NSW 中的“高速通道”。HNSW 正是在 NSW 基础上引入分层结构,进一步提高查找效率。
HNSW 结构
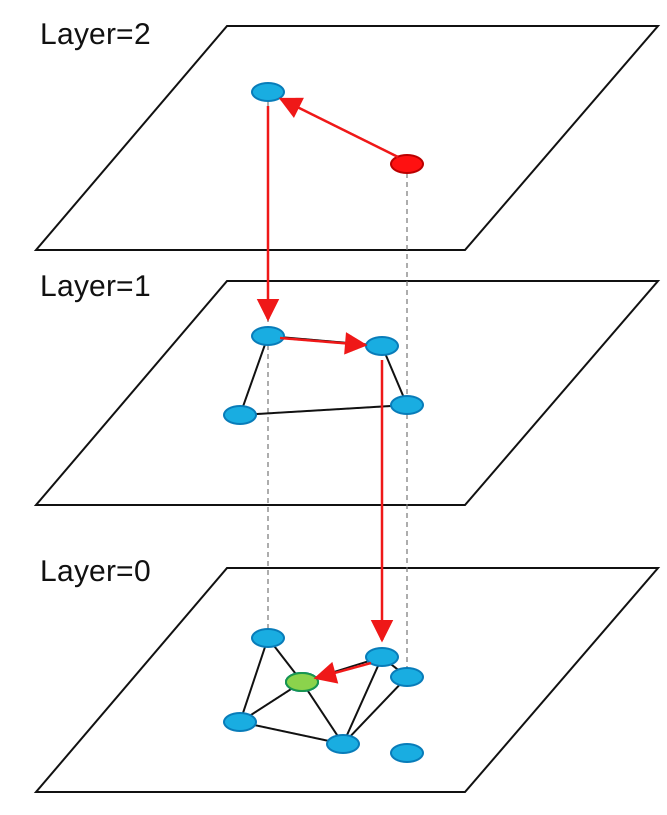
第 0 层包含所有节点。在第 i 层中的节点,也存在于所有满足 j <= i 的第 j 层中。每一层都可以理解成一个 NSW 图,不过其具体构建算法有所不同。
HNSW 查找算法
假设要从红色节点开始查找绿色节点。首先在最顶层查找离目标最近的节点,再以这个节点为入口进入下一层,继续寻找最近节点。不断向下,直到最底层中找到的最近节点成为最终结果。
HNSW 每一层内部的查找算法与 NSW 相同。
HNSW 构建算法
HNSW 的构建依赖一个随机函数。这个函数产生一个随机值,表示当前处理节点可以到达的最高层数。然后在每一层为当前节点寻找邻居并连线。每一层的整体构建步骤和 NSW 类似,区别在于 HNSW 除了直接寻找最近邻,还提出了另一种启发式邻居选择算法。
启发式邻居选择算法
一句话描述:为节点 q 启发式选择邻居时,要从候选列表中选择节点 c,并满足 c 到 q 的距离,小于 c 到当前已确定邻居集合中各节点的距离。
这个描述比较绕,可以看下面的示意图:
要为红色节点 Q 从候选邻居列表 (A, B, C, D, E, F, G) 中选择 4 个邻居。当前已经确定的邻居是 A 和 B。
最近邻选择算法会继续选择 C 和 F,而启发式选择算法会继续选择 D 和 E。
从结果来看,最近邻算法选出的邻居比较聚集,启发式算法选出的邻居更加发散。因此,启发式算法可以快速查找位于不同方向的目标节点。例如目标节点位于 E 附近时,最近邻算法需要更多迭代才能找到,而启发式算法可以更快定位。
最后
如有疏漏,欢迎指正讨论。