Elasticsearch 如何存储与检索海量向量
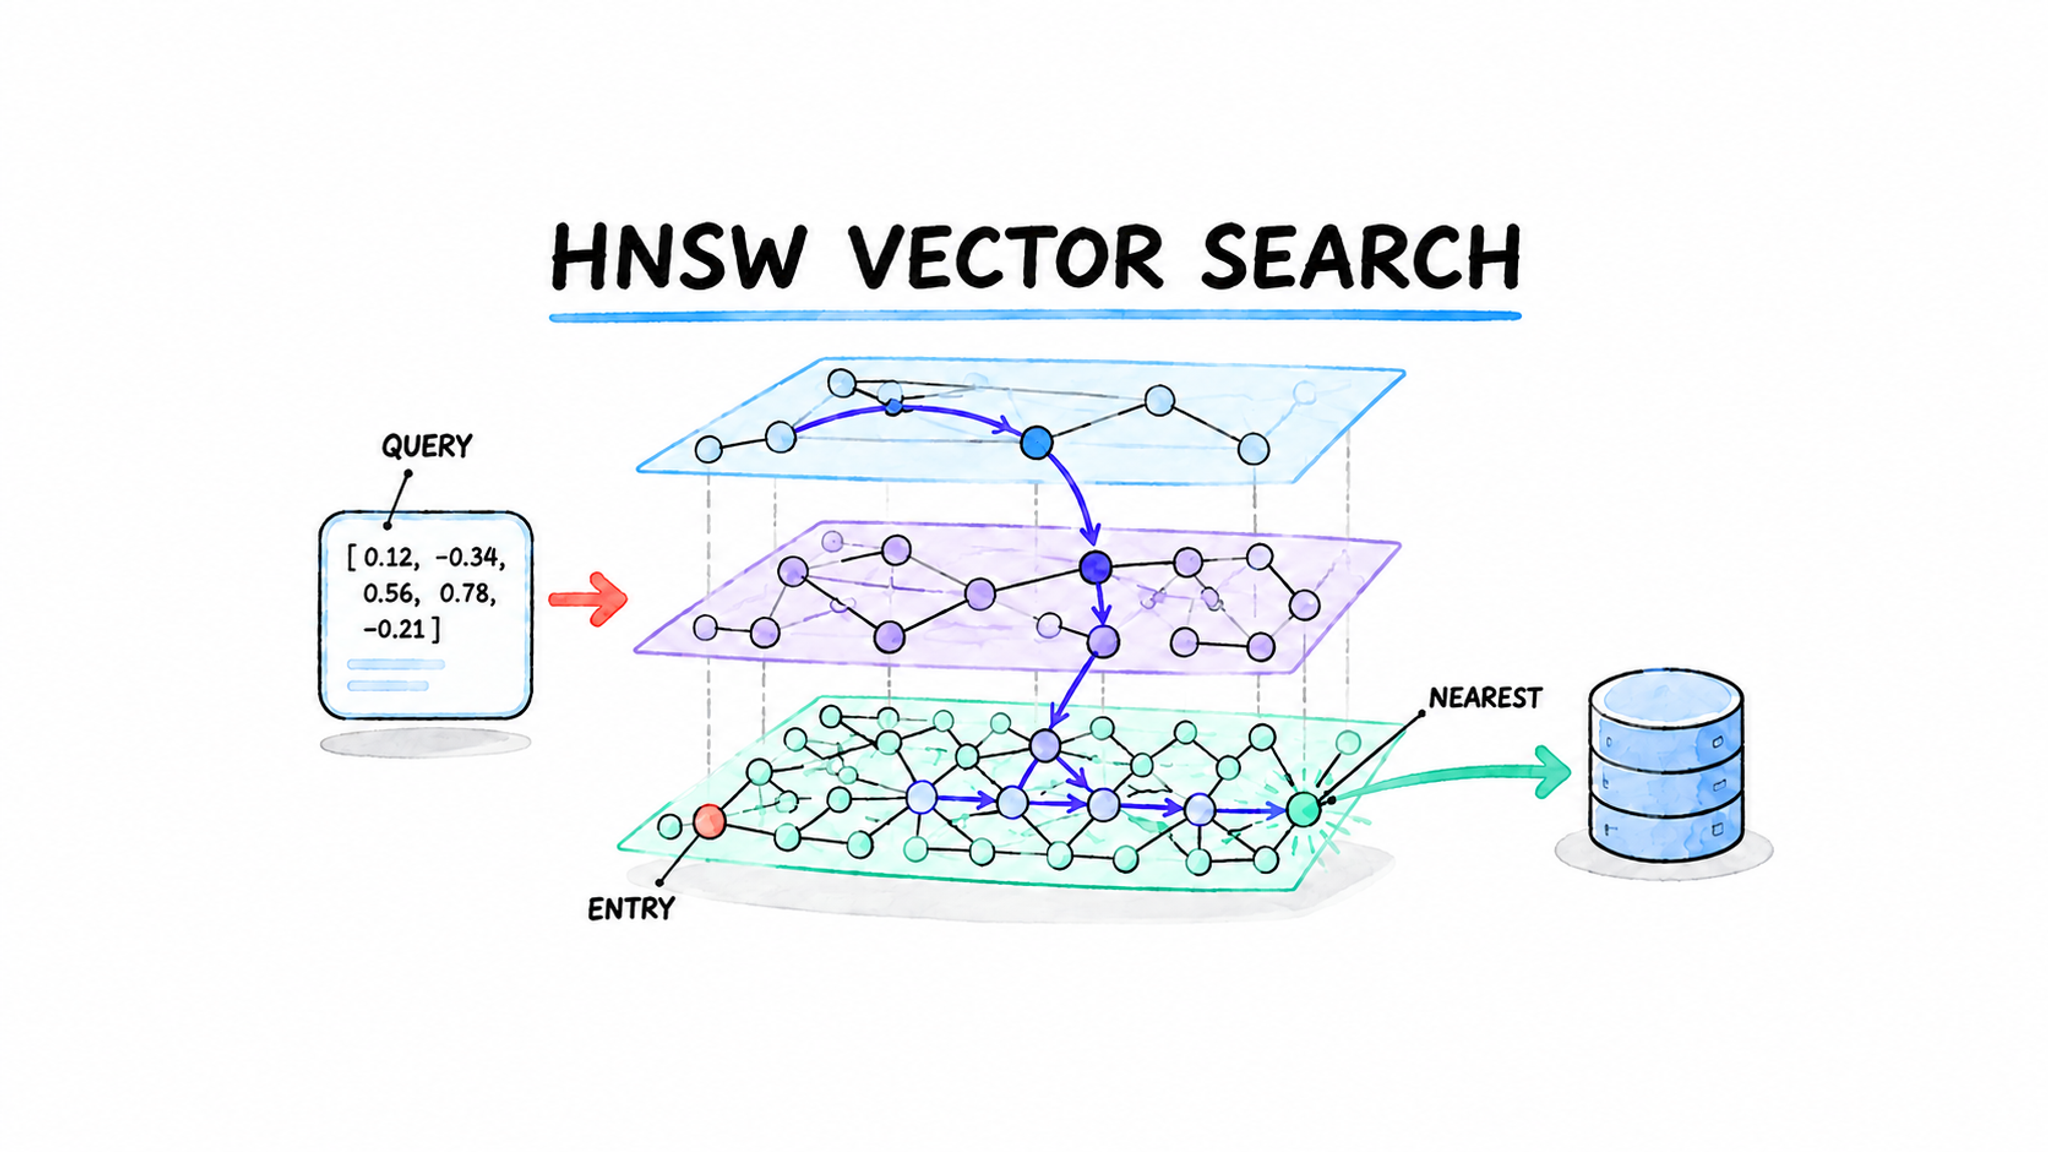
承接上一篇《向量数据库如何搜索海量数据?大白话讲透 HNSW》。上一篇讲的是 HNSW 在单机内存中的查找原理,这一篇回答剩下的工程问题:数据怎么分布到多台机器、向量在磁盘上长什么样、TB 级索引内存放不下时凭什么还能低延迟检索。
背景:从单机原理到分布式现实
先算一笔账。假设要做语义搜索:10 亿条文档,每条存一个 768 维的 float32 向量。
- 向量本体:768 × 4 字节 ≈ 3KB/条,10 亿条约 3TB;
- HNSW 图:每条向量还要保存邻居列表,每条额外几十到几百字节,加起来又是几十 GB;
- 这还没算普通字段的倒排索引和文档原文。
结论很直接:任何单机的内存都装不下,必须解决三个问题:
- 数据如何切分并分布到多台机器上?(分布式存储)
- 向量在单机的磁盘上如何组织,才能既支持更新又支持检索?(存储结构)
- 索引远大于内存时,搜索为什么还能做到毫秒级?(低延迟的真相)
Elasticsearch(下称 ES)对这三个问题各有一套答案,下面按”集群 → 分片 → 段 → 缓存”的顺序自顶向下讲。
一. 存储架构总览:从一个索引到一堆文件
ES 的底层是 Lucene——一个功能完整但完全没有分布式能力的单机搜索库。一个 Lucene 索引放在一台机器上,就是一组文件,仅此而已。ES 做的事情,是在 Lucene 外面套一层分布式外壳。
理解这层外壳,最有效的方式是先把概念分成两个视图——一个描述数据被划分成什么,一个描述这些划分由谁承载——再看两者如何对应。
1.1 两个视图:数据如何划分,划分如何落地
逻辑视图描述数据的划分与冗余:一个索引被切成几份数据、每份数据保留几个拷贝。三个概念:
- 索引(Index):逻辑上的文档集合。注意它在磁盘上并不存在,只是一个名字加一份配置;
- 分片(Shard):数据的切分单位。建索引时定好主分片数 N,全部文档按哈希分成 N 份,每一份就是一个分片。这里说的是”一份数据”——就像”分片 0 号那份数据”;
- 复制组(replication group):同一份数据的所有拷贝构成的小组。一份数据起初只有主分片这一个拷贝,配置 M 个副本后,ES 会为它复制出 M 个内容完全相同的拷贝,1 主 + M 副构成一个复制组。组内有且只有一个主分片,其余成员全是副本;索引有几个主分片,就有几个复制组。
这里有个容易踩的术语陷阱:“分片”一词在 ES 里既指那份数据,也指数据的每个拷贝实例。P0 和 R0 说的是实例——它们的内容一模一样,却是两个各自独立的 Lucene 索引,在磁盘上各占一个目录。就像 MySQL 的主从:同一个库的数据,主库和从库是两个独立的数据库实例,没人会把它们当成一个。ES 的分布式能力,全部建立在”把大索引切成很多个独立的小 Lucene 索引,再为每个索引做出相同拷贝”之上。
物理视图描述这些划分由谁承载、落成什么:哪台机器持有哪份拷贝,拷贝在磁盘上是什么形态。同样三个概念:
- 集群(Cluster)与节点(Node):集群是一组节点的集合,靠集群名互相发现;每个节点就是一个 ES 进程,跑在一台机器上;
- 磁盘目录:节点持有的每个分片实例,在它的数据盘上对应一个目录;
- segment(段):目录里带编号的不可变文件,倒排索引、向量数据、HNSW 图都存在其中,是存储、搜索、缓存的最小物理单位。
两个视图靠 master 的分片分配连接起来:master 决定每个复制组的成员分别放到哪个节点,并强制同一复制组的成员不落同一台机器——否则一台机器挂掉就可能整组覆没,副本也就失去了意义。全景关系如下图:
如上图,左边是逻辑视图:索引 products(3 主 1 副)被切成 3 个复制组、共 6 个分片实例;右边是物理视图:这 6 个实例被 master 撒到 3 个节点上,每个实例在节点磁盘上落成一个目录。看懂这张图只需要记住一句口诀:索引按复制组切分,master 把组分到节点,每个分片落成一个目录,目录里是 segment 文件。
1.2 节点的三种角色
物理视图里的节点不是铁板一块,生产集群中每个节点通常同时扮演多个角色:
- master 候选节点(ES进程):有资格竞选 master 的节点。同一时刻整个集群只有一个当选的 master,负责维护集群元数据(哪些分片在哪个节点上)。候选数量不是建集群时定死的,可以动态增减,约束只有一个:必须始终有过半候选节点在线,否则集群无法做出决策——这就是常说的”多数派”。生产上通常 3~5 个专职候选节点就够;
- 数据节点(ES进程):实际持有分片、执行读写;
- 协调节点(coordinating):接收客户端请求,负责拆分、转发、汇总。任何节点都能临时充当协调节点,客户端连上谁,谁就来协调。
1.3 磁盘上到底能看到什么
磁盘上真实存在的只有物理视图。你在任何节点上都搜不到叫 products 的目录,能找到的只有分片目录——每个分片在持有它的节点上占一个独立目录,里面躺着一堆带编号的文件,那就是 segment。刷新一次,目录里就多一批新文件;这些文件谁也改不了,它们从落盘那一刻起就不可变。
每个 segment 自己也是一组文件(倒排索引、向量数据、HNSW 图各占其中若干文件,3.2 节拆开看),大小没有固定值:取决于生成它时写入了多少文档——只写入几条时可能只有几 KB,高峰时一秒就能产出几百 MB;后台合并产出的段默认以 5GB 左右为上限(index.merge.policy.max_merged_segment)。它们始终是磁盘文件,不占 JVM 堆,被读取时进入操作系统的页缓存(5.1 节细说)。
把任意一个分片目录放大,就是下图——一个完整的 Lucene 索引,由若干 segment 叠成。新写入生成新 segment,删除和更新只是给旧文档打删除标记,物理空间等后台合并时再回收:
向量检索没有为自己另起一套存储,而是直接复用了这套结构:向量作为字段存在文档里,HNSW 图作为索引文件存在每个 segment 里。所以要看懂向量检索,必须先看懂分片和段。
二. 数据如何分片
2.1 路由:一条文档的去向由哈希决定
创建索引时指定主分片数,写入时 ES 用一个公式决定文档落在哪个分片:
1 | shard = hash(routing) % number_of_primary_shards |
- 默认
routing = _id(文档主键),哈希函数是 MurmurHash3; - 结果对主分片数取模,得到目标分片号。
写入链路(见上图下半部分):客户端把文档发给任意节点 → 该节点作为协调节点算出目标分片 → 转发给持有该主分片的节点 → 主分片写入成功后同步给副本分片 → 都确认后才返回成功。
2.2 为什么主分片数创建后不能改
因为路由公式里有取模。假如 3 个主分片扩成 6 个,同一条文档 hash("doc-42") % 6 的结果大概率变了,按旧公式写入的文档就再也找不到了。所以:
- 主分片数:建索引时一次性定死,要改只能重建索引(reindex);
- 副本分片数:随时可以调,只是同一份数据的拷贝数量。
容量规划的思路由此而来:预估数据总量,除以想给的单分片大小,得到主分片数。向量场景下单分片不宜过大——后面第五节会讲原因:单个分片的工作集(图 + 向量)要能装进单节点的页缓存。
不过”主分片数不能改”约束的只是索引参数,承载这些分片的节点数随时可以增减——ES 会在运行中把分片搬到新节点上,全程不停机,机制与操作见 2.5 节。
2.3 写入路径:近实时是怎么来的
文档到达分片后,在单机上经历三个阶段:
- 写入内存:文档先进入 JVM 堆里的 Indexing Buffer,同时追加一条事务日志(translog)。此时文档搜不到。
- refresh(默认每 1 秒):buffer 里的内容被生成一个新的 segment,写入操作系统的页缓存。从这一刻起文档可被搜索——但注意,只是进了页缓存,还没有真正落盘。这就是 ES”近实时(NRT)”的含义:写入约 1 秒后可搜。
- flush(定时或 translog 写满时触发):segment 文件 fsync 到磁盘持久化,然后清空 translog。translog 本身默认每次写请求都 fsync,所以两次 flush 之间发生崩溃,靠重放 translog 恢复。
对向量字段来说,这条路径上最重要的一件事是:HNSW 图是在 segment 生成阶段批量构建的——向量早已在 buffer 中,建图完成后图结构和向量数据一起写入 segment 文件。这也是向量索引写入开销大的原因之一:每条文档入库时不只是存下来,还要在图上跑一次近邻搜索来找到邻居、连上边(即上一篇讲的 HNSW 插入过程)。
2.4 复制组:主分片与副本的组织方式
第一章的全景图里已经见过复制组:一个复制组由 1 个主分片和它的全部副本构成,组内有且只有一个主分片,其余成员都是副本。由此可以理清三个容易绕晕的数量关系:主分片数 = 复制组个数(索引有几个主分片,就切成几个组);副本数 = 每个组内副本的个数(就是建索引时 number_of_replicas 配的那个值);分片实例总数 = 主分片数 × (1 + 副本数)。这一节看这个小组如何分工、如何容错。
如上图,复制组内有明确的分工和纪律:
- 写走主分片:写入只发给组内的主分片,主分片本地执行后并行同步给同步副本集中的每个副本,全部确认后才向客户端返回成功——也就是 2.1 节写入链路的第 ③ 步;
- 读在组内轮转:搜索请求到来时,每个复制组在主/副本中选其一执行,副本越多,搜索吞吐越高;
- 同组不同机:master 分配分片时会强制把同一复制组的成员放到不同节点上——否则一台机器挂掉就可能整组覆没,副本也就失去了意义。上图里 P0 和 R0、P1 和 R1、P2 和 R2 都刻意错开了节点。
这份**同步副本集(in-sync copies)**由 master 维护,记录每个复制组里当前健康的副本名单——“全部确认”等的是名单里的每一个成员。这套机制叫 primary-backup 模型(源自微软的 PacificA 论文),与 1.2 节 master 选举依赖的”多数派”并不是一回事:多数派面向集群元数据(选举、分片分配),同步副本集面向文档数据(写入确认),两者各管一层。
具体到一次写入,请求在节点之间是这样走的:客户端把请求发给 B 节点,B 只是协调者——它按 2.1 节的公式算出目标分片,从集群状态里查到主分片在 A 节点,就把请求转给 A。A 本地写入完成后,由主分片自己把这次操作并行转发给同步副本集里的每个副本——副本请求的发起者是 A,协调节点 B 自始至终只和 A 对话,不直接接触副本。副本收到的是一份待执行的操作,而不是拷贝来的文件:它像主分片一样在本地独立走一遍写入流程(写 buffer、写 translog、生成 segment),向量场景下每个副本还是一份独立的 Lucene 索引,HNSW 图各建各的(1.1 节)。所有副本写完后向 A 确认,全部收齐,A 才回复 B,B 再回复客户端。
名单界定了”全部”的范围,但它不等于所有物理副本——某个副本掉线时,主分片会先向 master 申请把它移出同步副本集,master 确认移除后才返回成功,同时另找节点重建这个副本(就是下文故障转移里发生的事)。所以副本故障不会卡死写入,只是短暂降低冗余。这也解释了 primary-backup 比多数派省拷贝的原因:官方说它”两份拷贝即可容错”,仲裁权在 master,而不必等数据写入的多数派。
副本确认的是操作已经进入 translog——也就是 2.3 节说的那份”默认每次写请求都 fsync”的日志。主分片和每个副本都要写 translog 成功才算数,所以”写入成功”意味着已持久化,而不是写进内存就返回。每个写操作还带递增的 sequence number:副本发现序号有空洞会主动找主分片补齐;主分片则维护 global checkpoint,记录所有同步副本都已确认的最高序号,副本重启或有新副本加入时,从这个位置之后做增量恢复,不必全量拷贝。
加副本对读和写的影响正好相反:搜索请求在组内主/副本间轮转,副本越多读吞吐越高;主分片等的是最慢那个副本,副本越多,踩到慢节点或网络抖动的概率越大——官方原话是”a single slow shard can slow down the entire replication group”。所以副本数是用写延迟换读吞吐的旋钮,读多写少的语义搜索场景,加副本是划算的。另外,写入前的 wait_for_active_shards(默认 1)只是事前体检,要求写开始时至少有 N 个实例处于 active 状态,否则直接拒绝;它不改变上面”同步副本集全部确认”的规则。
故障转移也以复制组为单位。上图下半部分模拟了 Node B 宕机:
- 复制组 1 的主分片 P1 随之丢失,master 把 Node A 上的副本 R1 提升为新主,组 0 和组 2 的数据毫发无损;
- 复制组 2 只损失了副本 R2,主分片 P2 还在,master 会另挑一个节点重建一个 P2 的新副本,把冗余补回来。
这也点明了扩缩容的边界:副本数随时可调——改一下配置,集群自动多复制或少复制一份数据;主分片数(复制组个数)动不了,原因还是 2.2 节的路由公式。所以水平扩容的常规路径是加节点 + 加副本,数据切分本身规划失误时,只能 reindex 重建索引。
2.5 扩容:加节点、加副本,为什么不用停机
主分片数动不了,但承载分片的节点随时可以加,ES 在运行中就把分片搬过去,全程不停机。底气来自 1.1 节两个视图的解耦:分片实例是自包含的独立 Lucene 索引,搬迁只是一次整份拷贝,不牵动其他分片;路由公式也没有变,文档仍属于同一个复制组,只是组员的物理位置换了。
搬迁(recovery)的机制是”先建后删”:
- 新节点加入集群,master 更新集群状态,把它纳入分配范围;
- master 从负载高(或磁盘紧张)的节点挑选分片,在新节点上建一份新拷贝,拷贝 segment 并靠 translog 追平拷贝期间的增量写入;
- 追平后新副本开始对外服务,旧副本被删除,搬迁完成。
整个过程分片始终至少有一个实例在线,所以读写不中断;加副本走的是同一套流程——多建一个实例、多拷一份数据,同样不停机。
操作就四件事:
- 加节点:新节点配相同的
cluster.name,discovery.seed_hosts指向现有节点,node.roles设为data(按数据层细分则用data_hot/data_content等,见 5.4 节),启动即可——注意新节点不要配cluster.initial_master_nodes,那是首次搭集群才用的。默认配置下 master 自动 rebalance,不用手工搬分片; - 加副本:调大
number_of_replicas,集群自动补齐拷贝; - 看进度:
GET _cat/allocation?v看磁盘与分片分布,GET _cat/recovery?v&active_only=true看搬迁进度; - 限速(可选):业务高峰用
indices.recovery.max_bytes_per_sec、cluster.routing.allocation.cluster_concurrency压低搬迁对带宽和磁盘的挤占。
两个前提要先确认:磁盘水位(low/high/flood 默认 85%/90%/95%;节点超过 high 会触发外迁,超过 flood 索引被置为只读,扩容前先把水位降下来);搬迁成本(每个分片是跨网络整份拷贝,大分片不是几分钟能搬完,加节点分散的是单节点压力,不改变数据切分粒度)。
缩容是反向操作:先用分配排除规则把待下线节点上的分片迁走,迁完再停进程,同样不停机。
三. 向量在分片里如何存储
3.1 先看 mapping
向量的存储、索引方式由字段映射决定:
1 | PUT /products |
几个关键点:
type: dense_vector:稠密向量字段,dims指定维度,必须与查询向量一致;index: true:为该字段构建 HNSW 索引(8.x 默认开启)。不开启就只能做精确暴力搜索;similarity:距离度量,常用cosine(余弦相似度)、l2_norm(欧氏距离)或dot_product(点积);index_options.type:hnsw为全精度;int8_hnsw(8.12 引入,8.14 起成为 float 向量的默认索引)为 int8 量化;bbq_hnsw(8.16 引入,9.1 起 384 维及以上默认)为二值量化,量化概念见第五节;m(默认 16):每个节点在每层最多保留的邻居数,就是上一篇 HNSW 里的 M;ef_construction(默认 100):建图时候选队列长度,越大图质量越好、建得越慢。
3.2 关键机制:每个 segment 一张独立的图
Lucene 的最小查询单元是 segment。向量索引也遵守这个规则:每个 segment 内部,为其中的向量独立构建一张完整的 HNSW 图——自己的入口点、自己的分层、自己的邻接表,段与段之间互不相通。
如上图,一个 segment 里并存着三类与检索相关的文件:
- 倒排索引:普通字段(文本、数值、keyword)的”词项 → 文档编号列表”,支撑关键词查询和过滤;
- 向量数据文件:dense_vector 字段的原始向量,按文档编号顺序紧凑排列;
- HNSW 图文件:图的入口点、层数和每个节点的邻居表。
三类文件靠**文档编号(doc id)**连接:图搜索或倒排查出编号,再到向量文件算距离,最后按编号取回 _source 原文。这个设计让向量检索可以和普通查询、过滤无缝组合。
“每段一图”带来两个直接后果:
- 搜索时必须把分片内每个段都查一遍。每个段各自从入口点开始贪心下降,找出本段的近邻候选,再合并。段越多,要遍历的图越多、越碎,单次搜索的总开销越大。不过它不是全量扫描:每张图只走对数级的贪心路径,所以分片的查询成本大致正比于段数,而不是正比于向量总量。
- 合并段时图要重建。后台 merge 把多个小段合并成大段时,向量数据可以直接搬运,但多张 HNSW 图不能简单拼接,需要在合并后的数据上重新连接图结构。这是向量索引”写放大”的重要来源,也是向量场景下数据写完后建议 force merge(见 5.4 节)的原因。
段的数量由后台合并控制,不会随写入次数无限膨胀——1.3 节提到的”后台合并”就是干这个的。Lucene 默认采用分层合并策略(TieredMergePolicy):把大小相近的段归入同一层,一层内的段数超过阈值(index.merge.policy.segments_per_tier,默认 10)就挑一批合并成更大的段,普通合并产出的段以 5GB 为上限。删除标记的文档在这一步被物理清除,空间随之回收。所以稳态下段的数量与分片的数据量相关,而不是与写入次数相关,常见的健康分片维持在几十个段的量级。容易失控的是持续高频的更新和删除:每秒 refresh 都产出新段,合并一旦跟不上,段数就会一路上涨;而向量段的合并还要重建 HNSW 图(上一条),比普通段更重,段数失控对向量检索的打击也更大。
3.3 不可变性的好处
segment 不可变(immutable)看似死板,实则是整个设计的基础:
- 不可变的数据结构不需要维护复杂锁和删除补偿,读请求完全不阻塞写请求;
- 不可变文件可以被操作系统放心地缓存——第五节的主角就是它;
- 更新和删除通过”写新段 + 旧文档打删除标记”实现,标记的文档在搜索时被过滤,物理空间在后台合并时回收。
四. 一次 kNN 查询的完整链路
4.1 先分清两个词:kNN 与 HNSW
到这里正好辨析一对容易混淆的概念:上一篇讲的 HNSW,与这一篇反复出现的 kNN。
两者的关系一句话可以讲清:kNN 是问题,HNSW 是解法之一。
- kNN(k-Nearest Neighbor,k 近邻搜索)是一个问题:给定查询向量,从库里找出距离最近的 k 条。它只描述目标,不规定怎么算。
- HNSW 是解决这个问题的一种算法与数据结构:把向量组织成分层图,从顶层入口贪心导航逼近目标区域,逐层下降,最终在第 0 层找出近似 top k。
解决 kNN 问题有两条路线:
| 路线 | 做法 | 结果 | 代表 |
|---|---|---|---|
| 精确 kNN(exact) | 逐条计算距离,全量扫描 | 100% 准确,但 O(n),海量数据下不可行 | 暴力扫描 |
| 近似 kNN(ANN) | 用索引结构剪枝,只碰一小部分数据 | 极快,但可能漏掉个别真近邻 | HNSW、IVF 等 |
ES 两条路线都支持:dense_vector 不建索引(index: false)时只能暴力扫,即上表的精确路线;建了 HNSW 索引(index: true),knn 查询默认走图搜索,即近似路线。后文说的”kNN 查询”,指的都是用 HNSW 执行的近似 kNN。
4.2 发起查询
1 | POST /products/_search |
k:最终想要的全局 top 10;num_candidates:每个分片在 HNSW 图上搜索时考察的候选数量,默认1.5 × k(上限 10000)。
4.3 scatter-gather:为什么必须广播所有分片
完整流程如上图:
- 请求到达某个节点,它成为协调节点;
- 协调节点把请求广播给索引的每个分片(每个分片在主/副本中选其一执行);
- 每个分片内部:逐 segment 运行 HNSW 搜索——每张图从自己的入口点开始,按上一篇讲的贪心 + 候选堆算法下降,各段的候选合并后,最多保留 num_candidates 个结果;
- 每个分片从中挑出本地 top k(doc id + 得分)返回给协调节点;
- 协调节点归并所有分片的 top k,得到全局 top k;
- fetch 阶段:协调节点拿着最终 doc id,回到对应分片取回
_source等字段,组装结果返回。
第 2 步是理解分布式向量检索的重点:关键词搜索可以按词项定位分片,数值范围查询可以裁剪分片,但向量相似度没有任何”路由”依据——查询向量的最近邻可能落在任何一个分片上,所以近似 kNN 永远是全分片广播,再归并。这也是分片数不宜过多的原因之一:分片越多,广播面越大,单次查询要打开的 HNSW 图越多。
4.4 带过滤的 kNN
实际业务很少做纯向量搜索,通常是”在这个类目下、价格区间内,找语义最相似的 top 10”。knn 支持 filter 参数:
1 | "knn": { |
ES 采用**先过滤后搜图(pre-filter)**的策略:先用倒排索引执行过滤,得到满足条件的文档编号位图,图搜索时只接受位图中的节点。一个实用的细节:当过滤后命中的文档数少于 num_candidates 时,ES 会直接退化为精确暴力搜索——候选都没几个了,扫一遍比绕图更快,召回还是 100%。
4.5 num_candidates:召回率与延迟的旋钮
HNSW 是近似算法,num_candidates 就是精度与速度的交换旋钮:
- 调大(如 1000、10000):每分片考察更多候选,召回率更接近精确解,但图上走的路更长,延迟上升;
- 调小:更快,但可能漏掉真正的近邻。
官方文档的建议是:从默认值起步,用带真实标注的查询评估召回率,逐步加大 num_candidates 直到召回和延迟达到业务平衡点。
五. TB 级索引,如何实现低延迟搜索
开头第三个问题的答案落在一份工作集上:HNSW 图,加上用于搜索的向量。官方文档的要求是:
HNSW 只有大部分向量数据和图结构驻留内存时,才能高效工作。
装不下时,搜索会频繁读盘,延迟随之上升。下面先看这份工作集存放在哪。
5.1 索引数据不进 JVM 堆,交给页缓存
ES 有个反直觉的设计:索引文件的数据几乎不占用 JVM 堆,文件读取由 Lucene 的存储层完成。默认的 hybridfs 会按文件类型选择方式:term dictionary、norms、doc values 等文件用 mmap(内存映射),其余文件——包括 HNSW 图和向量数据——走 NIO 读取。两种方式都不把数据装进 Java 堆,而是依赖操作系统的页缓存(Page Cache):读过的页留在内存里,下次访问直接命中;未命中才真正读盘。
如上图,一台数据节点的内存被分成职责分明的两层:
- JVM 堆(刻意小):只放集群状态、Indexing Buffer、查询执行上下文等。数据结构可控、体积小,避免大堆带来的 GC 停顿。这也是官方建议 JVM 堆不超过物理内存一半的原因——另一半是留给页缓存的;
- OS 页缓存(越大越好):缓存索引文件——HNSW 图、向量数据、倒排索引。谁缓存、谁淘汰,全部交给操作系统:按访问热度换入换出,进程重启后缓存依然有效(页缓存属于 OS,不属于 Java 进程)。
于是”内存够不够”这个问题,实际问的是”页缓存装不装得下工作集”。
5.2 HNSW 的访问模式:为什么工作集要驻留页缓存
回看上一篇的 HNSW 原理:一次搜索从顶层入口出发,逐层贪心下降,访问的节点数远小于全图规模(经验上接近对数级)。但这个”少”并不自动带来低延迟,关键在访问的方式:
- 跳转是随机的。搜索在图上不断跳转:读一个节点的邻居表,跳到若干邻居,逐个比较向量,再往外扩。数据在缓存里,这是几十纳秒的事;一旦不在,就变成磁盘随机读——SSD 上几十到几百微秒,HDD 上毫秒级,慢几个数量级;
- 访问过哪些节点,每次都不一样。查询向量不同,路径就不同。今天搜数码、明天搜服装,长期看图上大部分区域都会被访问到。查询分布高度集中时可能自然形成热区,但那是业务特征,不是 HNSW 的保证;
- 向量不按语义相邻摆放。节点的邻居表在文件里连续,但邻居节点本身、以及它们的向量,是按文档编号顺序落盘的,不按图上远近排列——一次跳转大概率跨页。
也就是说,HNSW 没有一个可靠机制保证”只碰一小块固定区域”。能不能低延迟,取决于工作集(图 + 向量)有多大比例在页缓存里。官方因此要求:数据节点的内存至少要能装下向量数据和索引结构;装不下时,搜索会频繁读盘,延迟急剧抖动。
工作集远大于缓存时,出路只有两条:加内存,或者把工作集压小。
5.3 量化:把工作集压进缓存
量化是近年 ES 向量检索最重要的优化,正是上一条给出的”第二条出路”:
- int8 标量量化(8.12 引入;8.14 起是 float 向量的默认索引):每维从 4 字节压到 1 字节,量化向量缩 4 倍;
- BBQ 二值量化(8.16 引入;9.1 起,384 维及以上的 float 向量默认启用):每维压到 1 bit,量化向量缩约 32 倍,配合 SIMD 位运算,距离计算还更快。
量化就是把每个维度上的高精度数值,换成低精度表示,用一点精度换大量空间。
但要看清”32 倍”指的是量化向量值本身,不是整个工作集。仍以 10 亿条、768 维、m=16 估算:
- 量化向量:int8 约 0.77TB;BBQ 按官方公式
条数 × (维度/8 + 14)约 110GB; - HNSW 图:约
10 亿 × 4 字节 × 16≈ 64GB——量化省不掉,图必须一起驻留; - 合计:BBQ 下约 174GB。相比 3TB 的原始向量,这是从”不可能装下”到”规划得当能装下”的跨越;但它也不是一条 96GB 的轻量方案,副本、普通字段、缓存余量都还要另算。
精度靠配套机制补偿:图搜索用压缩向量,过采样多取候选(常见约 3 倍),再用始终保留在磁盘上的原始 float 向量对候选重排(9.1 起有内置的 rescore_vector 配置;此前需要手工处理)。代价是磁盘占用上升:int8 约 +25%,BBQ 约 +3.1%。
工作集再压也装不下时,ES 9.2+ 提供面向内存受限场景的 bbq_disk(DiskBBQ):用聚类分块把随机读变成更可预测的顺序访问,不再要求整图驻留——那是另一条算法路线,超出本文讨论范围。
5.4 工程手段:让工作集更小、更整
最后是几个与架构配合的运维手段:
- force merge:把不再更新的索引合并成少量大 segment,图更少更整,kNN 不必”每段一搜”。官方强调只对只读索引考虑 force merge——它代价很高(临时占用大量磁盘,且可能生成不再参与普通合并的超大段);更经济的做法是批量导入期间关闭 refresh、调大
max_merged_segment,入库时就生成大段; - 冷热分层(data tiers):节点分成 hot / warm / cold / frozen 层,热查询命中的索引放 hot(内存大、SSD),低频历史数据逐层下沉(大容量磁盘,对查询延迟的要求相应放宽),把昂贵的页缓存留给真正被频繁访问的数据;
- 加副本:数据量不变时,增加副本能提升搜索吞吐(查询在组内按负载选一个副本执行);但每个副本都要占一份内存和磁盘,物理资源需求近似翻倍;
- 合理分片数:让”分片数 × 单片工作集 ÷ 数据节点数”落在单节点页缓存可容纳的范围内。分片太多会放大广播开销和段碎片,太少则单片工作集过大、难以驻留缓存,需要权衡。
六. 总结
回到开头的三个问题,ES 的答案串起来是一条完整的链路:
| 问题 | 答案 | 对应机制 |
|---|---|---|
| 海量数据如何分布到多台机器 | 索引切成分片,哈希路由,副本冗余 | hash(routing) % 主分片数,scatter-gather |
| 向量在单机如何存储 | 向量进 segment,每段一张独立的 HNSW 图,与倒排索引通过 doc id 关联 | dense_vector + 每 segment 一图 |
| 索引远大于内存,为何低延迟 | 数据不进 JVM 堆,靠页缓存;HNSW 随机跳转要求工作集(图 + 向量)驻留缓存;量化把工作集压到可驻留的规模 | 页缓存 + 量化 + force merge |
而一次查询的旅程是:客户端 → 协调节点 → 广播每个分片 → 逐段贪心走 HNSW 图 → 分片 top k → 归并全局 top k → fetch 原文 → 返回。
理解了这套结构,也就理解了向量场景下大部分调优建议的由来:为什么堆不能太大(页缓存)、为什么要 force merge(每段一图)、为什么分片不能太碎(全分片广播)、为什么要开量化(工作集驻留缓存)。原理清楚了,参数就不再是玄学。
参考资料
- Elasticsearch 官方文档:k-最近邻(kNN)搜索
- Elasticsearch 官方文档:dense_vector 字段类型
- Elasticsearch 官方文档:调优 kNN 搜索
- Elastic 官方博客:Vector search in Elasticsearch — integration & design rationale
- Elastic 官方博客:HNSW graph — how to improve Elasticsearch performance
- Elastic 官方博客:Elasticsearch 9.1 — BBQ by default & ACORN
- Elasticsearch 官方文档:高效 kNN 过滤
- Elasticsearch 官方文档:读写文档与 primary-backup 复制模型
- Elasticsearch 官方文档:translog 的 durability 设置
- Elasticsearch 官方文档:存储类型 hybridfs 与 mmap 范围
- Elasticsearch 官方文档:BBQ 量化与过采样